G1 速度阶梯:从步行到奔跑
摘要:本实验研究 Unitree G1 人形机器人的前进速度能力如何由训练命令分布决定。方法上继承 Isaac Lab 官方 Isaac-Velocity-Flat-G1-v0 任务,仅通过自定义配置子类覆盖前进速度命令范围 lin_vel_x 一项,奖励函数、观测、动作、网络结构与全部超参数保持官方原值不变,得到三个条件:官方范围 0–1.0 m/s(基线)、扩展范围 0–2.2 m/s(run2)与 0–4.5 m/s(sprint4)。每个扩展条件以 RSL-RL PPO 训练 3 个随机种子、每 run 1500 次迭代。独立评估(9 个策略、450 回合)显示:官方范围策略在 2.0 m/s 命令下三个种子中有两个整轮全部摔倒;把范围扩到 0–2.2 后,同一 2.0 m/s 命令下三个种子全部零摔、线速度 RMSE 0.040 ± 0.002 m/s;扩到 0–4.5 的策略在 4.0 m/s 命令下三个种子全部零摔、RMSE 0.080 ± 0.009 m/s,且腾空占比达 20.2%——在未修改任何奖励项的前提下自发形成了带腾空相的奔跑步态。核心结论是:官方为步行设计的奖励表本身足以支撑到奔跑速度,策略的速度能力边界主要由训练时见过的命令范围决定,而非奖励函数。
| 状态 | 已训练 ✓ 6 个正式 run(run2 / sprint4 各 3 种子)+ 复用基线 3 种子 |
| 机器人 | Unitree G1 minimal(23 自由度机身 + 三指手 14 关节 = 37 个受控关节;隐式 PD 关节位置执行器) |
| 技术路线 | 强化学习 · PPO · RSL-RL |
| 任务环境 | Isaac-Velocity-Flat-G1-v0(Isaac Lab 官方 Manager-based 任务) |
| 任务配置 | 自定义 cfg 子类:继承官方 G1FlatEnvCfg,仅覆盖 commands.base_velocity.ranges.lin_vel_x(run2 = (0, 2.2)、sprint4 = (0, 4.5));奖励、观测、动作、网络、超参数一律沿用官方值 |
| 并行环境数 | 4096 |
| 迭代 / 步数 | 1500 次迭代;每迭代 4096×24 步;单 run 约 147,456,000 步 |
| 训练设备 | NVIDIA GeForce RTX 5070 Ti(16 GB) |
| 真实训练耗时 | 6 个正式 run 合计约 7928 秒(2.20 小时);单 run 约 21.5–22.8 分钟 |
| 观测 / 动作维度 | 123 维 → 37 维(三条件相同) |
| 策略网络 | Actor 123→256→128→128→37;Critic 123→256→128→128→1;合计 167,243 个参数(与基线同构) |
| 关键结果 | sprint4 在 4.0 m/s 下三种子零摔、RMSE 0.080,腾空占比 20.2%(自发奔跑);官方范围基线在 2.0 m/s 下三种子中两个整轮全部摔倒 |
1背景与问题定义
Isaac Lab 官方 G1 平地任务要求机器人跟踪随机采样的底盘速度命令,其前进速度命令范围默认为 vₓ ∈ [0, 1.0] m/s。这一范围既定义了训练时机器人会遇到的速度,也隐含地划定了它"练过"的能力区间。本实验提出的问题是:如果只把这一个命令范围改大、其余全部不动,机器人能否学会更快的移动,速度的上限又在哪里?任务与被控系统如图 2 所示。
base_velocity 生成;躯干 torso_link 发生非法接触时回合失败终止。图中标注的 vₓ∈[0,1] 为官方默认范围,正是本实验作为研究变量加以扩展的对象。机器人:Unitree G1 minimal 资产,共 37 个受控关节。关节构成为:双腿 12 个(每侧 hip_yaw / hip_roll / hip_pitch / knee / ankle_pitch / ankle_roll),躯干 1 个(torso_joint),双臂 10 个(每侧 shoulder_pitch / shoulder_roll / shoulder_yaw / elbow_pitch / elbow_roll),双手指 14 个(G1 为三指灵巧手,每侧 7 个关节 = 拇指 3 + 食指 2 + 中指 2)。三个条件使用完全相同的 G1_MINIMAL_CFG 资产。
控制:控制量是与 37 个关节一一对应的关节位置偏移,而非期望速度本身。图 3 所示的链条是:策略输出动作 a → q* = q₀ + 0.5a 得到关节位置目标 → 隐式 PD/电机在物理仿真中产生力矩 → 形成站立、摆腿与速度跟踪。中间没有手写步态控制器;不同前进速度下的步态(步行、快步、奔跑)都是由同一套奖励与物理闭环学出,而不是为每档速度手工设计的。
a,经 q* = q₀ + 0.5a 转为 37 个关节位置目标,分别落到双腿、躯干、双臂和手指的受控关节;隐式 PD/电机据此在物理仿真中产生关节力矩。目标:最大化折扣累计奖励,使机器人在 20 秒回合内保持直立、不使躯干触地,并尽可能准确跟踪 (vₓ, vᵧ, ωz) 命令——其中 vₓ 的取值范围正是三个条件的唯一区别。三个条件的命令范围与各自的展示速度见图 4。
lin_vel_x 采样范围不同:基线 0–1.0(官方)、run2 0–2.2、sprint4 0–4.5 m/s;其余奖励、观测、动作、网络与超参数完全一致。两个扩展条件的展示速度取各自范围上限的约 90%(2.0/2.2、4.0/4.5),基线展示速度即其范围上限 1.0 m/s。按 MDP 表述,问题定义见表 2。
| 环境 | 4096 个并行 Isaac Lab GPU 物理环境,平地 plane,控制频率 50 Hz |
| 智能体 | RSL-RL PPO 的 Actor-Critic 策略 |
| 状态 / 观测 | 123 维本体观测与速度命令,构成见表 3 |
| 动作 | 37 维关节位置目标偏移 |
| 奖励 | 16 项加权和(官方 G1 flat 原表,三条件相同),见表 4 |
| 回合 | 20 秒到时正常结束;躯干接触地面提前终止 |
| 目标 | 最大化折扣累计回报,折扣因子 γ = 0.99 |
2理论基础
本实验沿用 PPO 作为连续控制算法。G1 速度跟踪任务具有高维连续动作、长时序稳定性要求和大量并行仿真的特征,适合 on-policy Actor-Critic:Actor 产生连续动作分布,Critic 估计状态价值以降低策略梯度方差。PPO 的核心约束是裁剪新旧策略概率比,避免单次更新过大导致步态崩溃;优势估计使用 GAE(λ),价值函数通过价值损失拟合回报,策略通过 surrogate loss 提升带正优势的动作概率。熵正则项控制动作分布的随机性。本实验三个条件的算法、网络与全部超参数完全相同,唯一的自变量是环境侧的命令采样范围。
命令范围与能力边界。在速度跟踪任务中,机器人每回合被下达一个从 lin_vel_x 范围内均匀采样的前进速度目标,并因跟踪该目标而获得奖励。因此训练分布决定了策略在训练中见过哪些速度:范围上限之外的速度在训练中从未出现,策略既没有为其优化过跟踪精度,也没有为其学过维持平衡所需的姿态与步频。把范围从 0–1.0 扩大到 0–2.2 或 0–4.5,等价于要求同一套奖励与网络在更宽的速度谱上都保持直立与跟踪——这既检验官方奖励表能支撑的速度上限,也检验"扩大命令范围"这一最小改动能否把能力边界整体外推。选择 PPO 的原因与基线条件一致:37 维连续动作适合策略梯度法、4096 并行环境提供充足样本、官方已给出可复现的 RSL-RL PPO 配置。
3实验框架
3.1网络结构
三个条件共用同一网络结构,如图 5、图 6 所示。Actor 与 Critic 共享 3 层隐藏层宽度(256、128、128),Actor 输出 37 维动作均值并带 37 个可学习 logσ,Critic 输出标量价值。实测 checkpoint 参数量:Actor 85,962(含 37 个 logσ)、Critic 81,281,合计 167,243——与官方基线完全一致,因为本实验没有改动网络。
3.2观测与动作
观测为 123 维,构成见表 3。值得指出的是,观测里包含 velocity_commands(3 维,即当前回合下达的 vₓ, vᵧ, ωz)——策略据此知道"这一回合要跑多快",从而在同一网络内对不同速度命令作出不同响应。这也是"扩大命令范围即可扩大能力"之所以成立的结构基础:速度目标是观测的一部分,网络本就具备按命令调整行为的输入通道。
| 项 | 维度 | 含义 | 训练期噪声 |
|---|---|---|---|
base_lin_vel | 3 | 躯干线速度 | Uniform [-0.1, 0.1] |
base_ang_vel | 3 | 躯干角速度 | Uniform [-0.2, 0.2] |
projected_gravity | 3 | 重力方向在机体系中的投影,表征姿态 | Uniform [-0.05, 0.05] |
velocity_commands | 3 | 目标 vₓ、vᵧ、ωz | 无 |
joint_pos | 37 | 关节相对默认位置 | Uniform [-0.01, 0.01] |
joint_vel | 37 | 关节相对速度 | Uniform [-1.5, 1.5] |
actions | 37 | 上一步动作 | 无 |
动作项为 joint_pos,维度 37;策略输出经 scale=0.5 缩放并以默认关节位置为 offset,得到目标关节位置。Play 配置关闭观测 corruption(G1 训练配置本未启用随机推搡,Play 变体中相应事件同样为空)。
3.3奖励函数
奖励在每个控制步按权重与控制步长累加。本实验的关键前提是这张表一项没改——三个条件都使用官方 G1 flat 的 16 个活跃奖励项(见表 4),主目标是线速度与 yaw 速度跟踪,双足步态项鼓励单支撑与摆脚,其余为稳定性与能耗正则。下文将说明:正是这张为 0–1.0 m/s 步行调好的奖励表,在命令范围扩大后无需任何修改就支撑出了 4 m/s 的奔跑步态。
| 奖励项 | 权重 | 作用 |
|---|---|---|
track_lin_vel_xy_exp | +1.0 | 指数核跟踪 xy 线速度命令 |
track_ang_vel_z_exp | +1.0 | 指数核跟踪 yaw 角速度命令 |
feet_air_time | +0.75 | 双足任务中鼓励非零命令下的单支撑/摆脚时间 |
termination_penalty | −200.0 | 提前失败终止重罚 |
flat_orientation_l2 | −1.0 | 惩罚躯干偏离水平姿态 |
dof_pos_limits | −1.0 | 惩罚踝关节接近位置限位 |
feet_slide | −0.1 | 惩罚触地脚滑动 |
joint_deviation_hip / arms / fingers / torso | −0.1 / −0.1 / −0.05 / −0.1 | 限制髋偏航/滚转、手臂、手指与躯干偏离默认姿态 |
lin_vel_z_l2 | −0.2 | 限制竖直方向速度 |
ang_vel_xy_l2 | −0.05 | 限制横滚/俯仰角速度 |
action_rate_l2 | −0.005 | 惩罚连续动作变化过大 |
dof_torques_l2 / dof_acc_l2 | −2e−6 / −1e−7 | 惩罚髋/膝力矩与加速度 |
3.4终止与复位
终止条件包含 time_out(20 秒,即 1000 个控制步)与 base_contact(torso_link 接触力超阈值,表示摔倒或躯干触地)。复位时根位姿在 x/y/yaw 范围内随机化,关节以默认姿态复位;Play 任务关闭随机外力与观测噪声。三个条件的终止与复位设置相同——唯一区别仍是复位后每回合从各自的 lin_vel_x 范围采样命令。
3.5训练流程
每次迭代中,PPO 在 4096 个并行环境中各收集 24 个控制步,共 98,304 条 transition;随后以 4 个 mini-batch、5 个 learning epoch 更新 Actor-Critic。1500 次迭代对应约 1.47 亿控制步。两个扩展条件各训练 3 个随机种子(42/43/44)。
3.6环境与实验设置
任务以 Isaac Lab 的 Manager-based workflow 组织。本实验的自定义只有一处:一个继承官方 G1FlatEnvCfg 的配置子类,在 __post_init__ 中覆盖前进速度命令范围,其余字段全部继承。核心差量如下(run2 条件;sprint4 条件仅范围上限改为 4.5):
class G1FlatSpeedRun2Cfg(G1FlatEnvCfg):
    def __post_init__(self):
        super().__post_init__()                                   # 先套用官方全部配置
        self.commands.base_velocity.ranges.lin_vel_x = (0.0, 2.2) # 唯一改动
软硬件环境与基线条件一致,只列版本:
复现命令。训练走本仓自定义任务入口(在官方 train.py 基础上先注册自定义任务):
TASK=G1-Flat-SpeedRun2-v0    scripts/train_custom.sh --seed 42 --run_name run2-s42       --logger wandb --log_project_name robot-learning-dashboard
TASK=G1-Flat-SpeedSprint4-v0 scripts/train_custom.sh --seed 42 --run_name sprint4-s42 --logger wandb --log_project_name robot-learning-dashboard
4实验结果
6 个正式 run(run2 / sprint4 各 3 种子)的记录与训练耗时见表 5,全部完成 1500 次迭代并写出最终 checkpoint。两个条件的训练回报曲线如图 7 所示。
| 条件 | seed | 公开标识 | W&B | real time | 末 100 回报 |
|---|---|---|---|---|---|
| run2 | 42 | run2-s42 | to21hu1f | 1289 s | 21.08 |
| run2 | 43 | run2-s43 | okkmk1u0 | 1314 s | 22.14 |
| run2 | 44 | run2-s44 | pis40k1k | 1339 s | 22.27 |
| sprint4 | 42 | sprint4-s42 | 3357kqdu | 1315 s | 8.19 |
| sprint4 | 43 | sprint4-s43 | pk9sudvo | 1301 s | 6.40 |
| sprint4 | 44 | sprint4-s44 | 5q42aiyw | 1370 s | 8.66 |
如图 7 所示,两个条件都在前若干百次迭代内进入稳定行走,随后回报缓慢上升;末段平均回合长度均接近 1000 步(run2 约 995、sprint4 约 989),说明两条件的多数回合都以 20 秒到时正常结束,而非中途摔倒终止——即便 sprint4 的命令范围高达 4.5 m/s。
5实验分析
5.1学习过程
两个条件的学习形态相似:前期先学会在宽速度谱上维持直立与基本迈步(回合长度快速上升到接近 1000 步),随后训练重点转向速度跟踪精度与动作平滑。差异主要体现在回报绝对水平——sprint4 末段回报(约 6.4–8.7)明显低于 run2(约 21.1–22.3),这不代表 sprint4 学得差,而是它被要求在最高 4.5 m/s 的命令上也跟踪与稳定,指数核跟踪奖励在高速误差下更难拿满、能耗与动作正则惩罚也更大。回合长度接近满值说明高回报差距来自"跟得多准",而非"是否摔倒"。
5.2辅助指标
两个条件的回合长度末段都稳定在约 988–996 步(满值 1000),训练期 base_contact 终止比例很低;这与后文独立评估中两条件在各自范围内的速度命令下零摔倒一致。sprint4 的动作幅度与步频在训练后段随高速命令上升,是它在评估中于 4 m/s 呈现奔跑步态(步频约 3.7 Hz、带腾空相)的训练期先兆。
5.3多种子稳定性
每个扩展条件覆盖 3 个随机种子。run2 三种子末段回报为 21.83 ± 0.65,sprint4 为 7.75 ± 1.19;两条件的种子间方差都不大,回合长度高度一致,说明"扩大命令范围即可获得更高速度能力"不是单一 checkpoint 的偶然结果。sprint4 的种子间回报方差略大,与更宽命令范围下高速段的探索差异有关。
5.4策略行为
视频 1 展示 run2 条件(seed 42)在 2.0 m/s 命令下的 9.98 秒跟随镜头回放,视频 2 为同一策略把评估回合扩展到 60 秒的耐力回放(仅评估用,不改训练配置)。
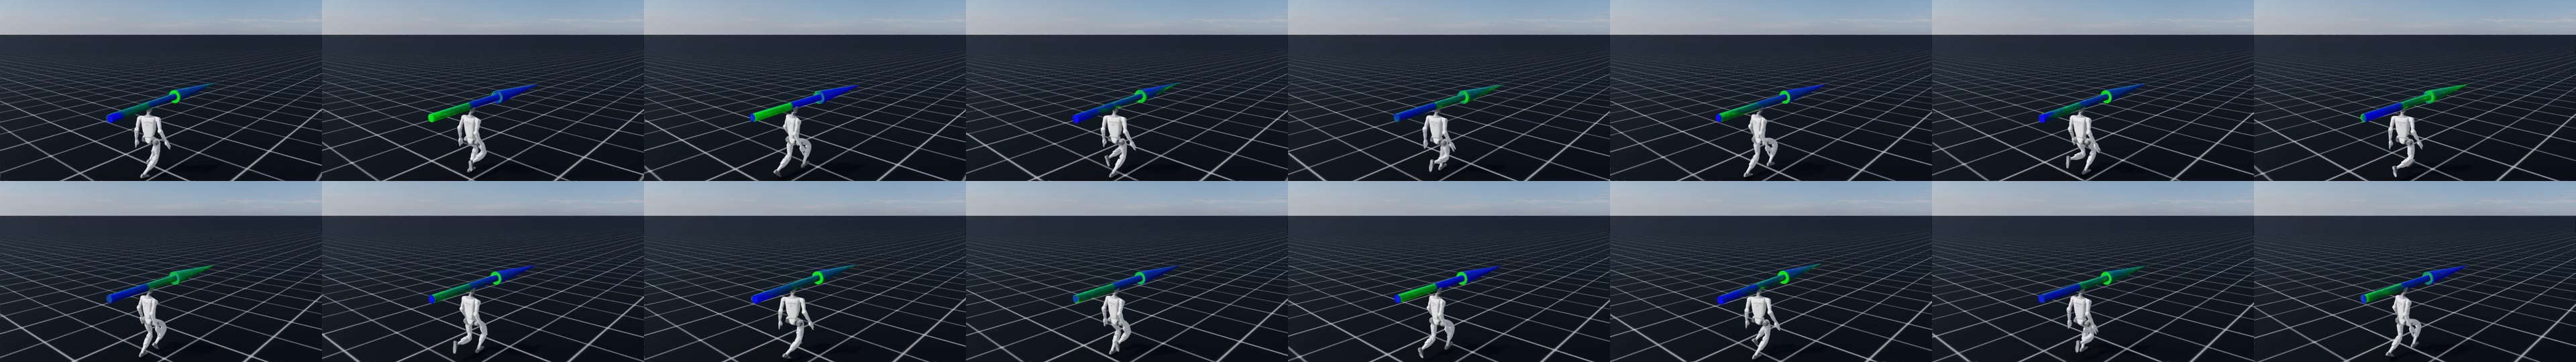
视频 3 展示 sprint4 条件(seed 42)在 4.0 m/s 命令下的奔跑;如图 8 所示,其抽帧序列中可见双脚同时离地的腾空相——这是步行与奔跑的运动学分界,也说明官方奖励表在未修改的情况下自发产生了奔跑步态。
6对比实验:命令范围如何决定速度能力
本节把三个条件放到同一组速度命令上直接对照,回答"扩大命令范围到底改变了什么"。实验设计见表 6:三个条件除 lin_vel_x 范围外完全一致,各在 1.0、2.0、4.0 m/s 三个固定前进命令上评估(每条件每速度 30 回合 = 3 种子 × 10 回合)。
| 条件 | lin_vel_x 范围 | Seeds | 每 run 迭代 | 并行环境 | 奖励/观测/动作 |
|---|---|---|---|---|---|
| 基线 | (0, 1.0) 官方 | 42, 43, 44 | 1500 | 4096 | 不变 |
| run2 | (0, 2.2) | 42, 43, 44 | 1500 | 4096 | 不变 |
| sprint4 | (0, 4.5) | 42, 43, 44 | 1500 | 4096 | 不变 |
核心对照是视频 4——其抽帧如图 9 所示——三个条件各在自己的展示速度上并排回放,速度差异一目了然:
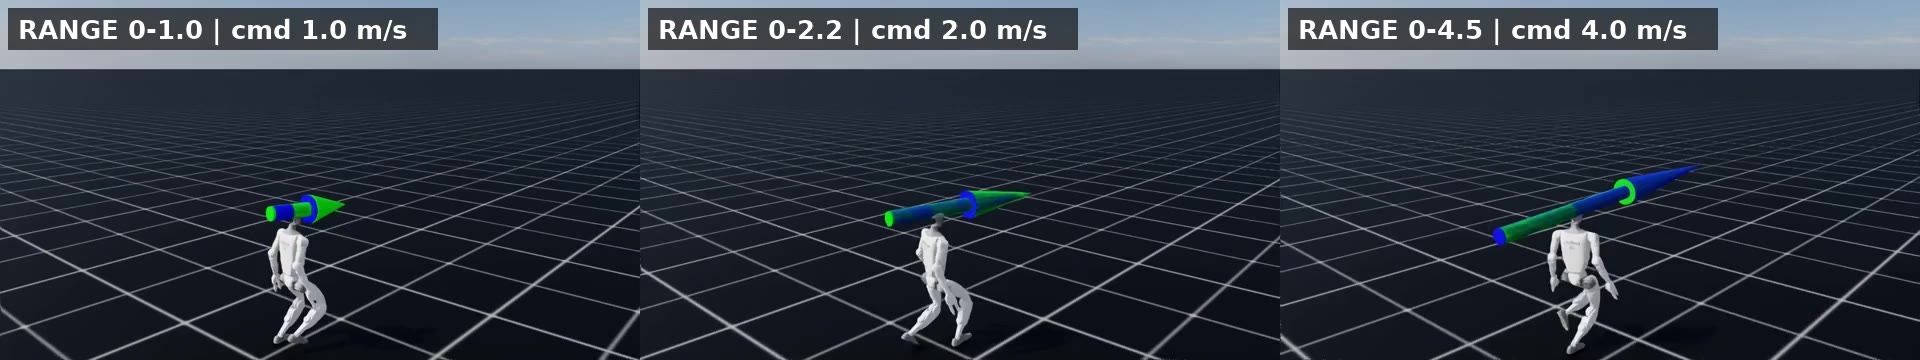
结果矩阵见表 7。关键对照是同一 2.0 m/s 命令下的基线与 run2:该速度落在基线训练范围(0–1.0)之外,基线三个种子中有两个(seed 42、43)10 回合全部摔倒、仅 seed 44 存活;而把范围扩到 0–2.2 的 run2 三个种子全部零摔、线速度 RMSE 仅 0.040 m/s。视频 5 把这组对照并排呈现,其失效过程如图 10 所示——左格基线策略在 2.0 m/s 命令下起步即失稳摔倒,右格 run2 在同一命令下稳定奔跑;这直观说明速度能力的边界由训练命令分布划定,而非机器人本体或奖励函数的硬限制。
| 条件\命令 | 1.0 m/s | 2.0 m/s | 4.0 m/s |
|---|---|---|---|
| 基线 (0–1.0) | 0 摔 · RMSE 0.117 | 20/30 摔(2 种子整轮摔) | 30/30 摔 |
| run2 (0–2.2) | 0 摔 · RMSE 0.041 | 0 摔 · RMSE 0.040 | 30/30 摔(范围外) |
| sprint4 (0–4.5) | 0 摔 · RMSE 0.089 | 0 摔 · RMSE 0.060 | 0 摔 · RMSE 0.080(腾空 20.2%) |

表 7 同时揭示了扩大范围的代价:sprint4 虽在 4.0 m/s 上稳定奔跑,但它在 1.0 m/s 上的跟踪 RMSE 为 0.089,高于把范围只扩到 0–2.2 的 run2(0.041)——极宽的命令范围把训练样本摊薄到 0–4.5 的整个速度谱,稀释了低速段的采样密度,低速跟踪精度因此下降。这是"训练分布决定行为质量"的另一面:范围不是越宽越好,应与目标速度区间匹配。run2 在 1.0 与 2.0 m/s 上都优于基线与 sprint4,是"范围恰好覆盖目标速度"时精度与能力兼得的例子。
7独立评估
第 6 节的对照来自固定命令回放;本节用独立评估管线在统一考卷下量化三个条件的可靠性与跟踪精度。评估在去随机化的 Play 环境中进行,推理确定性(取动作分布均值),9 个策略(3 条件 × 3 种子)在每个命令点前重设同一评估种子、同卷可比;每轮 10 个并行环境同时执行;逐回合明细与聚合结果落盘为 CSV 与 JSON 并记录 checkpoint 与场景配置哈希。协议见表 8,合计 9 策略 × 50 回合 = 450 回合。
| 场景 | 命令 | 回合 × 时长 | 检验目标 |
|---|---|---|---|
| 固定网格 | 1.0 / 2.0 / 4.0 m/s 确定性前进 | 每点 10 × 20 s | 各速度档的可靠性与跟踪精度 |
| 耐力 | 2.0 与 4.0 m/s 恒定前进 | 每点 10 × 60 s | 高速档超过训练回合 3 倍时长的连续运行 |
指标口径与基线条件一致:速度跟踪误差为基座系下水平速度误差的 L2 范数、对有效步取时间平均(剔除起步 1 秒稳定期与终止边界步,摔倒后数据不计);可靠性主指标为摔倒回合数与成功率(摔倒 = 躯干触地终止);步态量化按左右脚分别统计单步腾空时长、触地交替率与双脚同时离地占比(flight_fraction,奔跑步态该值显著为正)。核心结果见表 9。
| 命令 | 指标 | 基线 (0–1.0) | run2 (0–2.2) | sprint4 (0–4.5) |
|---|---|---|---|---|
| 1.0 m/s | 成功率 | 1.000 | 1.000 | 1.000 |
| 线速度 RMSE | 0.117 ± 0.024 | 0.041 ± 0.009 | 0.089 ± 0.038 | |
| 2.0 m/s | 成功率 | 0.333(2 种子整轮摔) | 1.000 | 1.000 |
| 摔倒数(/30) | 20 | 0 | 0 | |
| 线速度 RMSE | 0.179(幸存种子) | 0.040 ± 0.002 | 0.060 ± 0.015 | |
| 4.0 m/s | 成功率 | 0.000 | 0.000(范围外) | 1.000 |
| 摔倒数(/30) | 30 | 30 | 0 | |
| 线速度 RMSE | — | — | 0.080 ± 0.009 | |
| 双脚腾空占比 | — | — | 0.202 ± 0.014 | |
| 耐力 60 s | @2.0 摔倒(/30) | 20 | 0 | 0 |
| @4.0 摔倒(/30) | 30 | 30 | 0 |
表 9 给出三条一致的结论。第一,命令范围决定可用速度上限:基线(0–1.0)只在 1.0 m/s 可靠,2.0 m/s 三种子中两个整轮摔倒、4.0 m/s 全摔;run2(0–2.2)把可靠上限推到 2.0 m/s(三种子零摔、RMSE 0.040);sprint4(0–4.5)进一步在 4.0 m/s 三种子零摔。每个条件都在其范围内可靠、范围外迅速失效,可用速度与训练范围的对应关系清晰。第二,4.0 m/s 是真正的奔跑而非快走:sprint4 在该速度的双脚腾空占比达 20.2%,60 秒耐力回合同样零摔且维持相同腾空比例——奔跑步态是稳定持续的,不是短暂现象。第三,精度与范围需匹配:run2 在 1.0 与 2.0 m/s 的跟踪都优于其余条件,而 sprint4 因范围极宽在 1.0 m/s 上精度下降(RMSE 0.089 对 run2 的 0.041)。
视频 6 为 sprint4 在 4.0 m/s 命令下的 60 秒耐力回放:全程零摔并维持带腾空相的奔跑步态,说明上述"稳定持续"并非短时现象,而是可长时间保持的行为。
最值得强调的是:上述奔跑步态是在奖励表一项未改的情况下自发出现的。官方 G1 flat 的奖励只要求跟踪速度命令、不摔倒并满足若干正则,其中并没有"进入奔跑"或"产生腾空相"的显式项。当命令速度被提高到 4 m/s 时,策略发现带腾空相的奔跑是同时满足高速跟踪与省力正则的解,于是自行采用——这与显式奖励某种步态形状(后者容易被策略以表面达标的退化解利用)是相反的路径:在本实验中,通过在命令分布上做文章诱导出的奔跑,既满足高速跟踪又保持了达标的可靠性,未出现为迎合奖励而牺牲步态的退化解。
8局限性
第一,本实验只覆盖仿真平地,无外力扰动、地形、传感噪声或 sim-to-real 随机化。第二,评估使用单一评估种子(为 9 策略同卷可比而固定),靠每命令点 30 回合摊薄,未做多评估种子稳定性检验。第三,宽命令范围以牺牲低速段样本密度为代价,sprint4 在 1.0 m/s 上的跟踪精度不及范围较窄的 run2;本实验也未评估更自然的步态质量,只报告了可靠性与跟踪误差。第四,速度阶梯只取了 1/2/4 三档,未系统扫描"范围上限—可达速度"的关系曲线,也未定位官方奖励表失效的确切速度上限(4.5 m/s 范围已能稳定跑到 4.0 m/s,更高速度未测)。第五,评估只在纯前进命令下进行,未覆盖高速与转向、横移同时下达的复合命令。
9结论与未来工作
本实验通过仅覆盖前进速度命令范围一项,得到从步行到奔跑的速度阶梯:run2 把可靠速度上限从官方的 1.0 提升到 2.0 m/s(三种子零摔、RMSE 0.040),sprint4 进一步在 4.0 m/s 实现三种子零摔的奔跑(腾空占比 20.2%、60 秒耐力零摔)。核心结论是——在保持官方奖励、观测、网络与超参数完全不变的前提下,机器人的前进速度能力主要由训练命令分布决定,官方为步行调好的奖励表足以支撑到 4 m/s 的奔跑,且带腾空相的奔跑步态是速度提高后自发涌现的,而非被显式奖励塑形。这为后续工作提供了一个稳健的调节手段:与其为新行为手工设计奖励项,不如先检验能否通过调整任务/命令分布达成。未来工作包括系统扫描命令范围上限与可达速度的关系、在扩展速度上加入地形与扰动,以及把高速策略纳入统一评估考卷的抗扰动专项。
附录 · 关于本报告
数据来源。任务与 PPO 配置读取自 Isaac Lab 官方 G1 flat 配置与本实验的自定义子类;曲线与表格统计来自 6 个正式 run 的本地 TensorBoard 事件文件,末段口径为最后 100 迭代种子间 mean±std(ddof=1);参数量读自最终 checkpoint;视频与抽帧来自各条件的跟随镜头 Play 回放。第 6、7 节的评估数字来自代码仓评估管线的落盘产物(每回合明细 CSV 共 450 回合,聚合 JSON 记录 checkpoint 与场景配置的 SHA-256 哈希、Isaac Lab 版本与代码 git 提交号),摔倒计数经"CSV 逐行计数"与"聚合脚本"两条独立路径对账一致。
报告产物。训练曲线、对比曲线、回放与对照视频、抽帧均随页面仓库提供;跟随镜头回放脚本为 scripts/play_follow_camera.py,评估管线为代码仓 eval/ 目录(声明式场景 YAML + 采集/聚合两段式脚本)。
参考文献。
- J. Schulman, F. Wolski, P. Dhariwal, A. Radford, O. Klimov. Proximal Policy Optimization Algorithms. arXiv:1707.06347, 2017.
- J. Schulman, P. Moritz, S. Levine, M. Jordan, P. Abbeel. High-Dimensional Continuous Control Using Generalized Advantage Estimation. arXiv:1506.02438, 2015.
- N. Rudin, D. Hoeller, P. Reist, M. Hutter. Learning to Walk in Minutes Using Massively Parallel Deep Reinforcement Learning. CoRL 2021.
- Isaac Lab Project Developers. Isaac Lab, official manager-based locomotion velocity tasks and Unitree G1 configuration.