Cartpole 平衡实验
摘要:本实验研究倒立摆(Cartpole)的平衡控制问题:仅对小车施加水平力,使铰接其上的杆保持竖直不倒。方法上采用近端策略优化(PPO),在 Isaac Lab 的 Isaac-Cartpole-v0 环境中以 4096 个并行环境训练一个 4→32→32→1 的 MLP 策略,共 150 次迭代,训练循环耗时约 17 秒。结果表明:策略在第 36 次迭代达到满回合长度,最终平均回报 4.94,为理论上限 5.0 的 98.8%,收敛后无退化;回放显示策略能在约 1 秒内将随机倾斜的杆恢复竖直并保持至回合结束。
| 状态 | 已训练 ✓ run 2026-07-06_08-00-30 |
| 机器人 | Cartpole(倒立摆小车;2 个关节,滑轨关节主动 effort、杆关节被动) |
| 技术路线 | 强化学习 · PPO |
| 任务环境 | Isaac-Cartpole-v0(Isaac Lab) |
| 任务配置 | Isaac Lab 官方预设,未作任何修改 |
| 并行环境数 | 4096 |
| 训练迭代数 | 150(每次迭代学习一批新采集的经验) |
| 训练设备 | NVIDIA GeForce RTX 5070 Ti(16 GB) |
| 训练耗时 | 约 17 秒(采集 11.3 s + 更新 5.3 s,不含仿真器启动) |
| 观测 / 动作维度 | 4 维 → 1 维 |
| 策略网络 | MLP,两个隐藏层 × 32,ELU 激活;Actor 与 Critic 合计 2,499 个参数 |
| 最终平均回报 | 4.94(理论上限 5.0 的 98.8%) |
| 回合步数 | 300 / 300(满回合,全程不倒) |
1背景与问题定义
本任务通过强化学习训练一个策略,使倒立摆(Cartpole)保持平衡不倒。被控系统如图 2 所示。
slider_to_cart 沿水平滑轨平移,杆经被动铰接关节 cart_to_pole 绕小车自由转动;控制输入是施加于小车的水平力 F,θ 为杆偏离竖直方向的角度,小车位置越出 ±3 m 边界则回合失败终止。机器人:一辆小车与一根铰接于其上的杆,共两个关节——slider_to_cart(小车沿滑轨水平平移)与 cart_to_pole(杆绕小车自由转动)。其中小车滑轨关节为主动驱动,杆关节为被动铰接。
控制:策略每个控制步只输出一个水平力,作用在 slider_to_cart 上。水平力改变小车加速度,小车作为杆的支点移动,进而改变杆的角速度与角度;从“推小车”到“保持杆竖直”之间没有手写平衡控制器,全部由策略学出。
目标:使杆保持竖直不倒,且小车不越出边界。
本任务是一个经典的欠驱动问题:无法直接对杆施力,只能推动小车,借助小车的加减速间接维持杆的平衡。
按强化学习的标准框架(马尔可夫决策过程,MDP),问题的各要素定义见表 2:
| 环境 | Isaac-Cartpole-v0,Isaac Lab 提供的 GPU 并行物理仿真环境 |
| 智能体 | 控制小车的策略网络 π(结构见第 3.1 节) |
| 状态 / 观测 | 4 维连续向量:小车位置、杆角度、小车速度、杆角速度(第 3.2 节) |
| 动作 | 1 维连续量:施加于小车滑轨的水平力(第 3.2 节) |
| 奖励 | 5 项加权和:存活奖励 + 失败重罚 + 三个小权重塑形罚项(第 3.3 节) |
| 回合 | 5 秒(300 个控制步)到时正常结束;小车出界则提前失败终止(第 3.4 节) |
| 目标 | 最大化折扣累计回报,折扣因子 γ = 0.99 |
2理论基础
第 1 节将平衡控制表述为一个 MDP:智能体在每个控制步观测系统状态、输出动作、获得标量奖励,目标是最大化折扣累计回报。强化学习不依赖标注数据,而是通过与环境的反复交互,从奖励信号中学习控制策略——这正适合本任务:我们能够写出"什么算好"(杆竖直、不出界),却难以为每个状态标注"该施多大的力"。
强化学习的求解方法大体分为两族。价值法(如 Q-learning、DQN)学习每个状态–动作对的价值,再取价值最大的动作,天然适合动作可枚举的离散问题;本任务的动作是连续的水平力,无法枚举,因此采用策略梯度法——直接参数化策略并沿提升期望回报的方向更新参数。纯策略梯度的估计方差较大,实践中普遍采用 Actor-Critic 架构降低方差:Actor 即策略本身,负责输出动作;Critic 估计状态价值 V(s),为策略更新提供基准,仅在训练期使用。
更新的方向由优势(advantage)决定:A = 实际回报 − V(s),即某一动作相对 Critic 预期的好坏程度。优势的最小构件是时序差分误差 δ = r + γ·V(s′) − V(s),多步 δ 经 GAE(λ) 加权聚合为更稳定的优势估计,以在偏差与方差之间取得折中。训练同时优化三项:策略损失(记 Loss/surrogate)按优势加权调整各动作的概率;价值损失(记 Loss/value)使 Critic 的预测逼近实际回报;熵正则项对动作分布的随机性给予小额奖励,防止策略过早收敛到次优解。
策略梯度方法的实用难点在于更新步长:单次过大的更新可能使策略崩溃且难以恢复。PPO(Proximal Policy Optimization,近端策略优化)的处理方式是裁剪:当新旧策略的概率比越出 [1−ε, 1+ε] 区间时,其对优化目标的贡献被截断,从而失去继续外推的梯度激励,使每次更新仅前进一小步。
本实验选用 PPO 的依据有四:任务动作连续,属于策略梯度法的适用域;本实验采用数千个并行环境采样,与 PPO 这类 on-policy 算法的大批量数据需求恰好匹配;PPO 实现简单、对超参数不敏感,官方默认配置通常无需调整;它也是机器人运动控制领域常用的事实标准算法,并与 RSL-RL 等训练框架有成熟配套。
3实验框架
本节完整描述本实验的构成:策略由两个神经网络组成(3.1),读入 4 维观测、输出 1 维力(3.2),其行为由一组奖励规则塑造(3.3),回合的起止方式决定了训练所见的状态分布(3.4),PPO 在大量并行环境中迭代优化上述网络(3.5),最后给出运行环境、全部超参数与复现方式(3.6)。
3.1网络结构
强化学习训练调整的对象是神经网络的参数,而非机器人本身。本实验采用 Actor-Critic 架构,两个网络结构完全相同(4→32→32→1 的 MLP、ELU 激活),但承担不同职责、输出不同的量,其架构分别如图 3 与图 4 所示。网络规模很小:Actor 1,250 个参数(含 1 个可学习的动作标准差)、Critic 1,249 个参数,合计 2,499 个(实测自检查点文件)。
3.2观测与动作
观测空间(4 维,两个网络共用)。按固定顺序拼接为一个 4 维向量,各维均为相对默认姿态的偏差量,构成见表 3:
| # | 观测量 | 物理含义 | 取数函数 |
|---|---|---|---|
| 1 | slider_to_cart 位置 | 小车偏离中点的距离(m) | joint_pos_rel |
| 2 | cart_to_pole 角度 | 杆偏离竖直的角度(rad) | |
| 3 | slider_to_cart 速度 | 小车的平移速度 | joint_vel_rel |
| 4 | cart_to_pole 角速度 | 杆的转动角速度 |
动作空间(1 维)。策略在每个控制步输出一个标量:
3.3奖励函数
各项奖励在每个控制步按权重 × 控制步长(1/60 s)累加计入回报——权重描述的是"每秒的得分速率"而非单步得分。奖励由 1 个主要目标(alive)+ 1 个失败重罚(terminating)+ 3 个小权重塑形项组成——"主目标 + 失败重罚 + 小权重塑形"是奖励设计中十分常见的组合。五项权重的构成如图 5 所示。
下面逐项说明各项的定义、设计动机,以及移除后的影响:
3.4终止与复位
3.5训练流程
一次训练迭代包含以下四步,共循环 150 次:
- 收集经验。4096 个环境各以当前策略推进 16 步,共采集 65,536 条 (观测, 动作, 奖励, 下一观测) 样本。
- 计算优势。逐步计算时序差分误差 δ,并经 GAE(λ=0.95) 聚合为优势估计(定义见第 2 节)。
- 更新网络。将样本划分为 4 个 16,384 的小批量,重复训练 5 遍;每遍计算策略损失、价值损失与熵正则项(三者的含义见第 2 节),反向传播(梯度范数上限 1.0)、以 Adam 更新,并按 KL 自适应调整学习率。
- 返回第 1 步,循环至第 150 次迭代。
3.6环境与设置
任务环境 Isaac-Cartpole-v0 来自 Isaac Lab 官方任务包,按其 Manager-based 工作流(ManagerBasedRLEnv)组织:观测、动作、奖励、终止等要素以声明式的配置类组合定义、相互解耦——第 3.2 至 3.4 节描述的各要素即分别对应其中一块配置,本实验未作任何修改。
硬件与软件环境(标准环境,仅列版本,不逐条解释)
Rollout(经验收集)
PPO 算法超参数
评价指标
复现命令
cd /home/jeff/IsaacLab
./isaaclab.sh -p scripts/reinforcement_learning/rsl_rl/train.py \
    --task Isaac-Cartpole-v0 --headless \
    --logger wandb --log_project_name robot-learning-dashboard
命令未覆盖任何影响训练结果的超参——随机种子、迭代数、并行环境数均取任务注册的默认配置(42 / 150 / 4096),仅设置无渲染运行与日志选项,同机重跑即可复现。曲线同时写入本地 TensorBoard 与 wandb,本地部分由 scripts/export_run.py 导出为本页数据。
4实验结果
本次训练共 150 次迭代,累计约 983 万步仿真;训练循环总耗时约 17 秒(经验采集 11.3 秒、网络更新 5.3 秒,不含仿真器启动与场景加载),平均吞吐约每秒 60 万步。总体结果:平均回报由初始的 0.13 收敛至 4.94;平均回合长度由 12.8 步升至 300 步满值(自第 36 次迭代起);此后不再出现失败终止。全部训练曲线如图 6 所示,逐条解读见第 5 节。
5实验分析
5.1学习过程
将图 6 中的主曲线(回报、回合长度)与两条终止曲线对照阅读,可以清晰地看到学习过程经历了四个阶段:
5.2辅助指标
以上为行为层面的变化;辅助曲线则反映网络内部的状态,且多条曲线之间可相互印证:
5.3理论上限
该任务的回报上限可以精确计算。按第 3.3 节的累加规则,一个满回合 5 秒内 alive 项至多贡献 1.0 × 5 = 5.0,其余四项均为罚项,只会向下扣减,因此理论上限为 5.0。实测值 4.94,与上限相差的 0.06 主要来自 pole_pos 与两项速度惩罚的微小常驻扣分——杆无法在数学意义上做到绝对竖直与绝对静止。可见策略已非常接近该任务的性能上限,继续训练的边际收益趋近于零。
5.4策略行为
为直观检验收敛策略的实际行为,以下回放由 play.py 加载最终检查点 model_149.pt 在同一环境中录制(时长 5 秒,即一个完整回合):
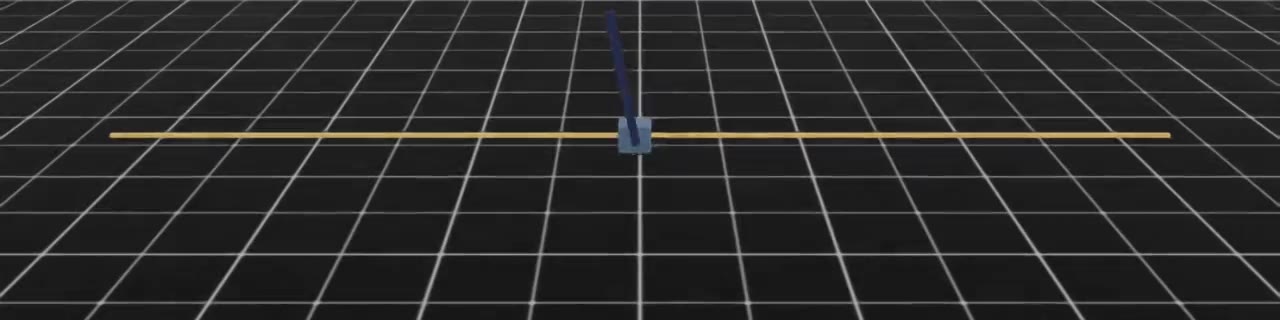 t ≈ 0.1 s · 初始倾斜
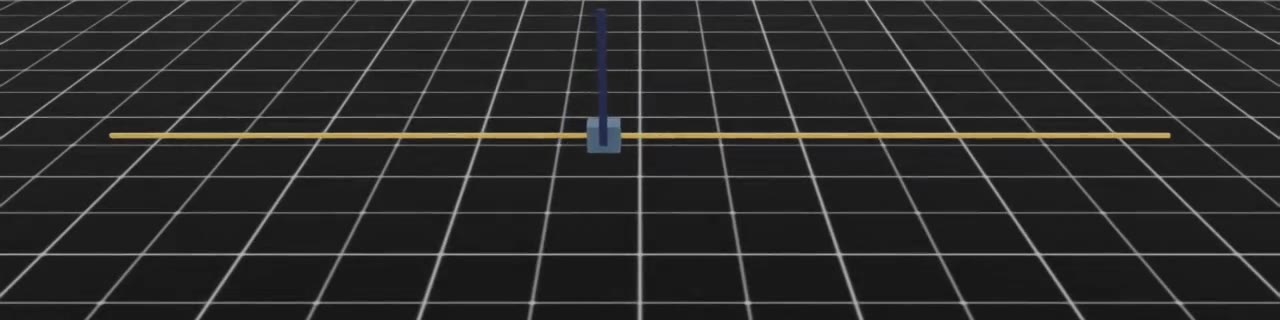 t ≈ 1 s · 恢复竖直
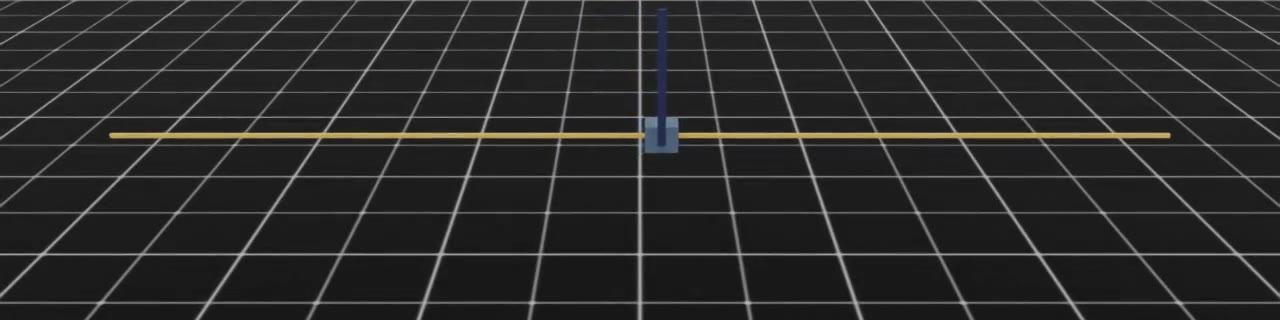 t ≈ 4 s · 持续保持
如图 7 所示,回合开始时杆因复位随机化带有明显的初始倾角(左);策略在约 1 秒内将杆恢复至竖直(中);此后直至回合结束,杆始终保持竖直,小车仅在滑轨中段小幅平移以维持平衡(右)。整段回放中未出现大幅往返或接近边界的行为,与第 5.2 节分项奖励的量化结论(杆角误差贴近零、速度惩罚极小)一致。
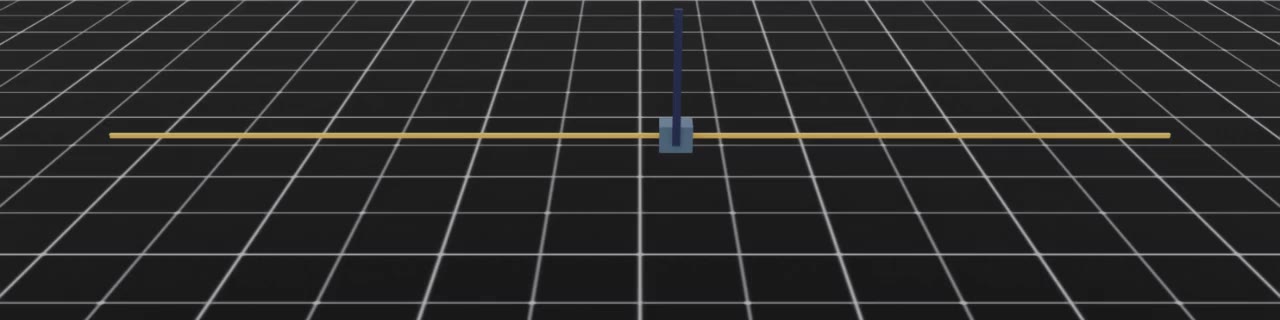
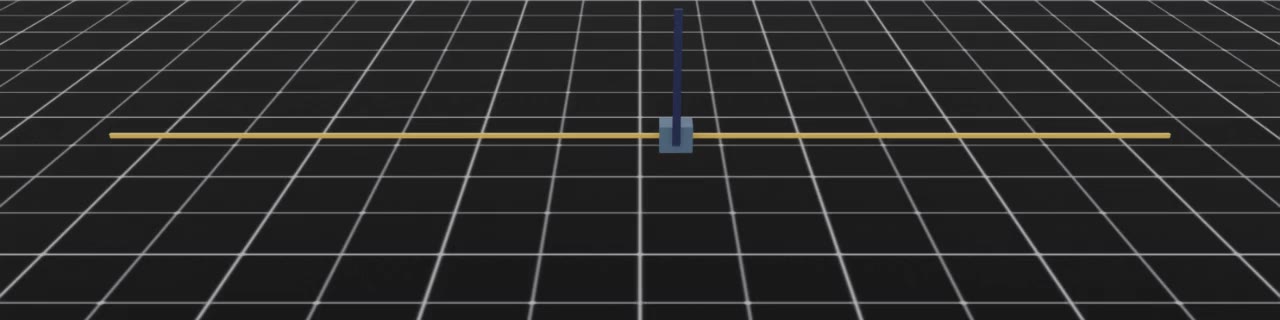
60 秒耐力测试。训练配置中的回合长度为 5 秒——这是训练阶段的设计选择:5 秒足以判定稳定性,而频繁复位可使策略在更多样的初始状态上训练,因此常规回放至多 5 秒即复位。为检验策略能否长时间维持平衡,另行录制了一段将回合长度覆盖为 60 秒的加时回放(env.episode_length_s=60,仅评估用,训练配置不变):
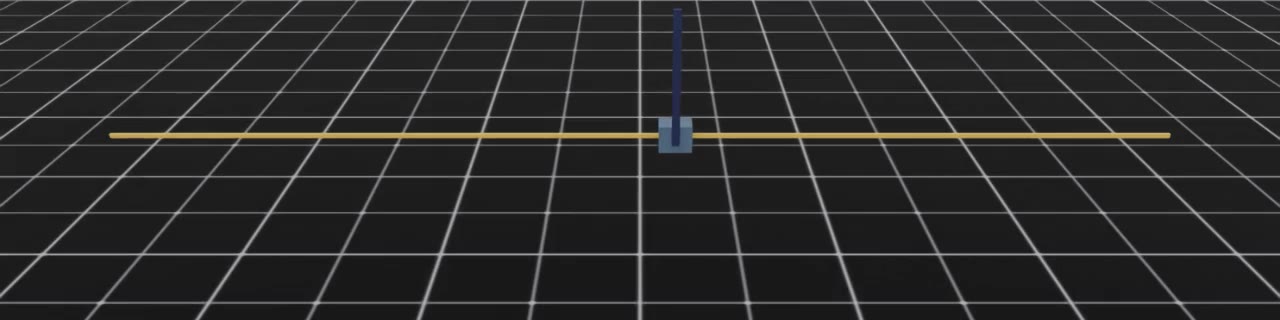 t ≈ 10 s
 t ≈ 35 s
 t ≈ 59 s
如图 8 所示,整段 60 秒回放中未发生任何失败:杆始终保持竖直,小车始终停留在滑轨中段。这与平衡问题的性质一致——策略一旦将系统稳定在竖直不动点附近,维持 5 秒与维持 60 秒并无本质差别;决定成败的是最初一秒左右的恢复阶段,而非之后的保持阶段。
6局限性
本报告存在三点局限:
- 单种子的单次运行。未运行多个随机种子,因而无法给出方差与置信区间。对首个实验尚可接受,但正式的对比实验(如奖励项消融)至少需 3 个随机种子方具说服力。
- 直接读取训练曲线。未设置独立的评估流程(关闭随机化、固定初始状态、运行 N 个回合作统计);独立评估管线将在后续实验中建设。
- 未测试鲁棒性。全程无外力扰动、无参数域随机化,抗扰动能力无从评估;鲁棒性将在后续行走任务中重点考察。
7结论与未来工作
结论。在 4096 个并行环境、150 次迭代(训练循环约 17 秒)内,PPO 策略稳定收敛:最终平均回报 4.94,达到理论上限的 98.8%,自第 36 次迭代起满回合无失败,平台期无退化,回放确认策略能将随机倾斜的杆稳定恢复并保持竖直(60 秒加时回放亦全程无失败),可判定任务完成。方法层面,Isaac Lab 官方默认配置未作任何修改即收敛,表明"主目标 + 失败重罚 + 小权重塑形"的奖励设计与 PPO 默认超参数在该低维任务上已完全够用。
未来工作。下一个实验为 Ant 四足行走,其观测与动作维度均将提升一个量级,用于检验同一套 PPO 配置在更高维任务上是否依然有效(具体维度以其实验页为准)。独立评估管线与多种子统计将随后续实验逐步建设。
附录 · 关于本报告
理论深度。本报告是一份实验记录,第 2 节的理论仅陈述至读懂本实验所需的程度;完整的推导与讨论请参阅下列文献。
数据来源。正文全部配置数值取自本机 Isaac Lab 2.3.2 的配置文件;训练曲线由真实 run(2026-07-06_08-00-30)的本地 TensorBoard 导出;训练耗时与网络参数量分别实测自该 run 的事件文件与检查点;回放视频与帧由 play.py 加载 model_149.pt 录制。均未作人工修饰。
参考文献。
- J. Schulman, F. Wolski, P. Dhariwal, A. Radford, O. Klimov. Proximal Policy Optimization Algorithms. arXiv:1707.06347, 2017.(PPO 原论文)
- J. Schulman, P. Moritz, S. Levine, M. Jordan, P. Abbeel. High-Dimensional Continuous Control Using Generalized Advantage Estimation. arXiv:1506.02438, 2015.(GAE 原论文)
- N. Rudin, D. Hoeller, P. Reist, M. Hutter. Learning to Walk in Minutes Using Massively Parallel Deep Reinforcement Learning. CoRL 2021, arXiv:2109.11978.(其配套开源库 rsl_rl 即本实验的训练框架)
- M. Mittal et al. Orbit: A Unified Simulation Framework for Interactive Robot Learning Environments. IEEE RA-L, 2023, arXiv:2301.04195.(该框架现已更名为 Isaac Lab,本实验环境来自其官方任务包)
- R. S. Sutton, A. G. Barto. Reinforcement Learning: An Introduction (2nd ed.). MIT Press, 2018.(强化学习标准教科书)