Ant 四足行走实验
摘要:本实验研究四足机器人 Ant 的平地行走问题:以 8 个关节力矩为控制量,使机器人朝固定目标方向持续行走且不摔倒。方法上采用近端策略优化(PPO),在 Isaac Lab 的 Isaac-Ant-v0 环境中以 4096 个并行环境训练一个 60→400→200→100→8 的 MLP 策略,共 1000 次迭代(约 1.31 亿步,训练循环耗时约 4.9 分钟);并以 3 个随机种子 × 3 种配置的消融实验检验能耗惩罚与熵正则的作用。结果表明:策略平均回报由 −0.46 升至 129.9,平均回合长度达 951/960 步;回放显示策略以对角步态持续前进。收敛后仍有约 7% 的回合以摔倒告终,说明该行走任务仍存在残余失败模式。
| 状态 | 已训练 ✓ run 2026-07-07_08-19-22_base-s42(另有 8 个消融 run,见第 6 节) |
| 机器人 | Ant(四足;8 个力矩驱动关节,直接 effort 执行器) |
| 技术路线 | 强化学习 · PPO |
| 任务环境 | Isaac-Ant-v0(Isaac Lab) |
| 任务配置 | Isaac Lab 官方预设;主 run 未修改,消融 run 仅命令行覆盖单个参数(见第 6 节) |
| 并行环境数 | 4096 |
| 训练迭代数 | 1000(单迭代 131,072 步,总计约 1.31 亿步) |
| 训练设备 | NVIDIA GeForce RTX 5070 Ti(16 GB) |
| 训练耗时 | 约 4.9 分钟 / run(采集 206 s + 更新 85 s,不含仿真器启动;吞吐约 45 万步/秒) |
| 观测 / 动作维度 | 60 维 → 8 维 |
| 策略网络 | MLP,三个隐藏层 400/200/100,ELU 激活;Actor 与 Critic 合计 250,317 个参数 |
| 最终平均回报 | 129.9(末 100 迭代均值 122.5;本任务无精确理论上限) |
| 回合步数 | 951 / 960(末 100 迭代均值 908.7;约 7% 回合仍以摔倒终止) |
| 消融实验 | 3 条件 × 3 种子共 9 个 run(能耗惩罚 / 熵正则,见第 6 节) |
1背景与问题定义
本任务通过强化学习训练一个策略,使四足机器人 Ant 朝固定目标方向持续行走。被控系统如图 2 所示。
.*_leg + 踝 .*_foot),共 8 个可驱动关节;任务目标为朝 +x 方向的远处目标点 (1000, 0, 0) 行走,躯干高度低于 0.31 m 判定摔倒、回合失败终止。机器人:躯干 + 4 条腿共 8 个力矩驱动关节——4 个髋关节(.*_leg)与 4 个踝关节(.*_foot,初始角 ±45°);执行器无内置刚度与阻尼,策略输出即关节力矩。
控制:策略每个控制步能做的唯一一件事,是给这 8 个关节各输出一个力矩,如图 3 所示。力矩驱动腿绕关节摆动,四条腿的摆动配合成周期性步态,机器人由此前进——从"出力矩"到"会走路"之间没有任何手写的控制器,全部由策略学出。
.*_leg)与踝(.*_foot)——各受一个力矩 τ 驱动(弧形箭头);4 条腿共 8 个力矩,即策略的全部输出。执行器无内置刚度与阻尼,网络输出经缩放后直接作为关节力矩(细节见第 3.2 节)。目标:朝 +x 方向的目标点 (1000, 0, 0) 持续行走——目标足够远,等价于"一直往前走";同时保持躯干直立不摔倒。
本任务的主要难点在于高维连续控制与接触动力学:策略须协调 4 条腿形成周期性步态;足端离地、触地与摩擦带来高度非线性的状态转移;且"走得快"(前进奖励)与"走得稳"(不摔倒)、"走得省"(能耗惩罚)之间存在多目标权衡。
按 MDP 框架,问题的各要素定义见表 2:
| 环境 | Isaac-Ant-v0,Isaac Lab 提供的 GPU 并行物理仿真环境(Manager-based) |
| 智能体 | 控制 8 个关节的策略网络 π(结构见第 3.1 节) |
| 状态 / 观测 | 60 维连续向量:躯干运动状态、关节状态、足端受力、上一步动作(第 3.2 节) |
| 动作 | 8 维连续量:各关节力矩(第 3.2 节) |
| 奖励 | 7 项加权和:前进 + 存活 + 直立/朝向奖励 + 三类正则惩罚(第 3.3 节) |
| 回合 | 16 秒(960 个控制步)到时正常结束;躯干高度 < 0.31 m 则摔倒终止(第 3.4 节) |
| 目标 | 最大化折扣累计回报,折扣因子 γ = 0.99 |
2理论基础
本实验将任务表述为 MDP,并采用 Actor-Critic 架构与 PPO 算法求解。优势 A = 实际回报 − V(s) 用于评估动作相对 Critic 预期的好坏;GAE(λ) 将多步时序差分误差聚合为更稳定的优势估计;PPO 通过裁剪新旧策略概率比,限制单次更新幅度,降低步态突然崩溃的风险。
PPO 对任务的假设较少:只要动作连续、奖励可计算,复杂性主要由网络容量与交互数据量吸收。本实验采用 400/200/100 的隐藏层宽度,并以约 1.31 亿步交互数据训练策略;这种以大规模并行采样支撑 on-policy 更新的方式,是 PPO 在机器人运动控制中常用的实践路径。
本任务的主奖励是前进速度(progress),走得越快回报越高,不存在可解析计算的回报上限。因此第 5 节的分析以多种子间的一致性与消融对照作为收敛质量的定量参照。
3实验框架
本节完整描述本实验的构成:策略由两个神经网络组成(3.1),读入 60 维观测、输出 8 维关节力矩(3.2),其行为由 7 项奖励塑造(3.3),回合的起止方式见 3.4,PPO 训练流程见 3.5,运行环境与全部超参数见 3.6。
3.1网络结构
Actor 与 Critic 仍为同构 MLP(60→400→200→100→输出,ELU 激活),架构分别如图 4 与图 5 所示。网络容量需要匹配 60 维观测与 8 维动作的表达需求:Actor 125,516 个参数(含 8 个可学习的动作标准差)、Critic 124,801 个,合计 250,317 个(实测自检查点文件),属于小型但足够表达该任务策略的 MLP。
3.2观测与动作
观测空间(60 维,两个网络共用)。由 11 个观测项按固定顺序拼接而成,构成见表 3。除本体运动状态外,还包含足端六维力/力矩(接触信息)与上一步动作——前者让策略"感到"脚何时触地,后者为力矩控制提供了动作连续性的参照。
| # | 观测项 | 物理含义 | 维度 |
|---|---|---|---|
| 1 | base_height | 躯干离地高度 | 1 |
| 2 | base_lin_vel | 躯干线速度 | 3 |
| 3 | base_ang_vel | 躯干角速度 | 3 |
| 4 | base_yaw_roll | 躯干偏航与滚转角 | 2 |
| 5 | base_angle_to_target | 朝向与目标方向的夹角 | 1 |
| 6 | base_up_proj | 躯干竖直度(up 向量投影) | 1 |
| 7 | base_heading_proj | 前进方向对准度(heading 投影) | 1 |
| 8 | joint_pos_norm | 8 关节位置(按限位归一化) | 8 |
| 9 | joint_vel_rel | 8 关节速度(×0.2 缩放) | 8 |
| 10 | feet_body_forces | 4 足端各 6 维力/力矩(×0.1 缩放) | 24 |
| 11 | actions | 上一控制步的动作 | 8 |
动作空间(8 维)。策略在每个控制步输出 8 个标量:
3.3奖励函数
各项奖励按权重 × 控制步长(1/60 s)逐步累加。奖励构成为 1 个主目标(progress,前进)+ 3 个正向辅助(alive / upright / move_to_target)+ 3 个正则惩罚(action_l2 / energy / joint_pos_limits);姿态、朝向与能耗项共同约束步态质量。七项权重的构成如图 6 所示。
下面逐项说明各项的定义、设计动机,以及移除后的影响(其中 energy 项的"若移除"推断在第 6 节以真实消融实验检验):
3.4终止与复位
3.5训练流程
一次训练迭代包含以下四步,共循环 1000 次:
- 收集经验。4096 个环境各以当前策略推进 32 步,共采集 131,072 条样本。
- 计算优势。逐步计算时序差分误差 δ,并经 GAE(λ=0.95) 聚合为优势估计。
- 更新网络。样本划分为 4 个 32,768 的小批量,重复训练 5 遍;计算策略损失与价值损失(本任务熵正则系数为 0,见 3.6 与第 6 节),反向传播(梯度范数上限 1.0)、Adam 更新、按 KL 自适应调整学习率。
- 返回第 1 步,循环至第 1000 次迭代。
3.6环境与设置
任务环境 Isaac-Ant-v0 来自 Isaac Lab 官方任务包,按 Manager-based 工作流组织(各要素为声明式配置、相互解耦)。本实验的主 run 未对官方配置作任何修改;消融 run 仅经命令行覆盖单个参数(第 6 节)。
硬件与软件环境(标准环境,仅列版本)
Rollout(经验收集)
PPO 算法超参数
评价指标
复现命令(主 run;消融 run 的覆盖参数见第 6 节表 4)
cd /home/jeff/IsaacLab
./isaaclab.sh -p scripts/reinforcement_learning/rsl_rl/train.py \
    --task Isaac-Ant-v0 --headless --run_name base-s42
命令未覆盖任何影响训练结果的超参——随机种子、迭代数、并行环境数均取任务注册的默认配置(42 / 1000 / 4096)。曲线写入本地 TensorBoard,由 scripts/export_run.py 导出为本页数据。
4实验结果
主 run(baseline,种子 42)共 1000 次迭代、约 1.31 亿步仿真;训练循环总耗时约 4.9 分钟(经验采集 206 秒、网络更新 85 秒,不含仿真器启动),平均吞吐约每秒 45 万步。总体结果:平均回报由初始的 −0.46 升至 129.9(末 100 迭代均值 122.5);平均回合长度由 19.7 步升至 951 步(上限 960,末 100 迭代均值 908.7);收敛后仍有约 7% 的回合以摔倒终止。全部训练曲线如图 7 所示,逐条解读见第 5 节。
5实验分析
5.1学习过程
将图 7 中的主曲线与终止占比曲线对照阅读,本次学习大致分为三个阶段:
5.2辅助指标
5.3多种子稳定性
本任务没有可解析计算的回报上限,收敛质量以多种子间的一致性作定量参照。基线配置以 3 个随机种子(42 / 43 / 44)独立重复训练,回报曲线如图 8 所示:三条曲线形态一致,末 100 迭代均值分别为 122.5、116.7、122.1,种子间统计为 120.4 ± 3.2(标准差仅为均值的 2.7%);平均回合长度 906.3 ± 2.6 步、摔倒占比 7.0% ± 0.7% 同样高度一致。可以认为主 run 的结论不依赖于特定种子。
5.4策略行为
以下回放由跟随镜头录制(加载主 run 最终检查点 model_999.pt,时长 16 秒即一个完整回合;镜头随机器人移动,地面网格的流动反映实际前进):
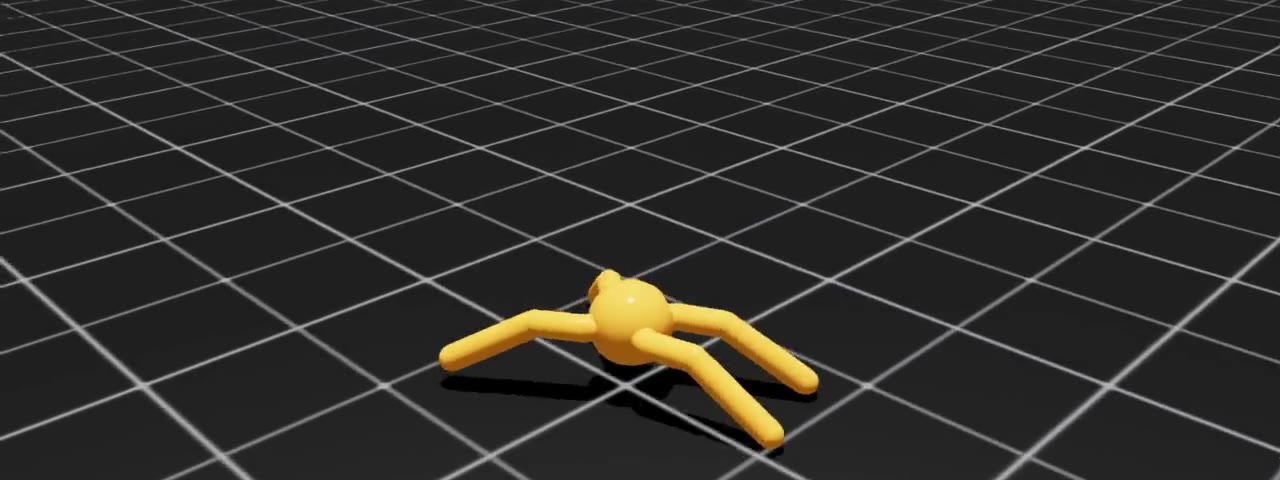 t ≈ 1 s
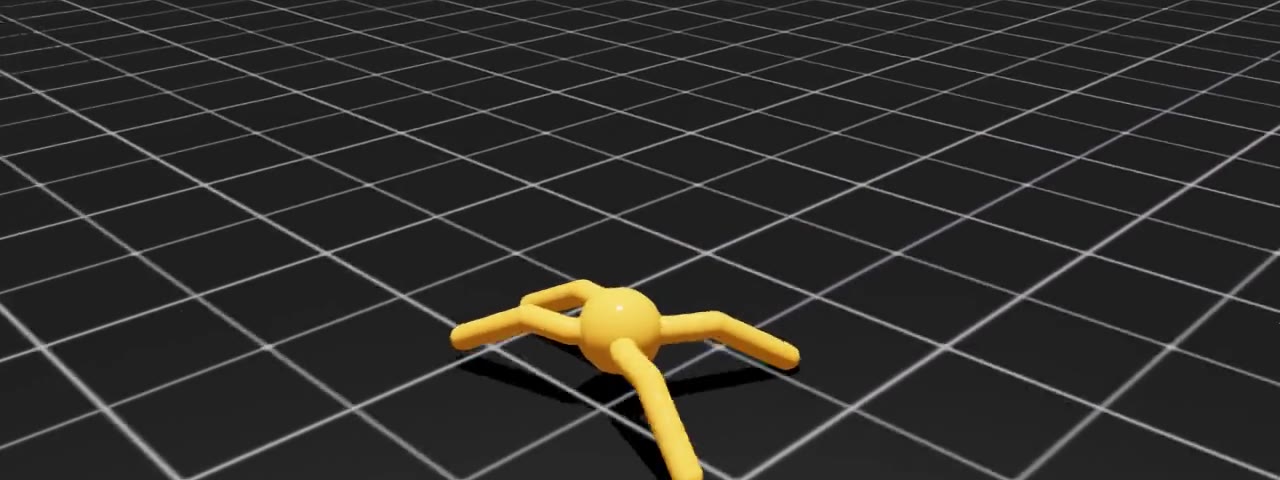 t ≈ 8 s
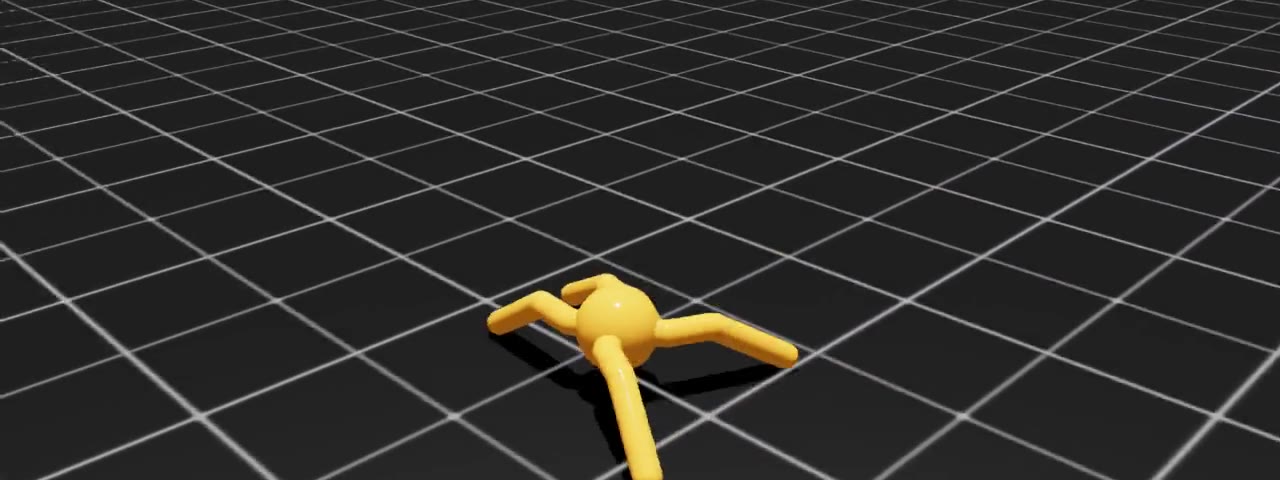 t ≈ 15 s
如图 9 所示,策略全程保持躯干撑起、四腿交替支撑前进,未出现拖行或翻倒;视频中可见其以近似对角交替的方式协调四腿、朝固定方向持续行走。
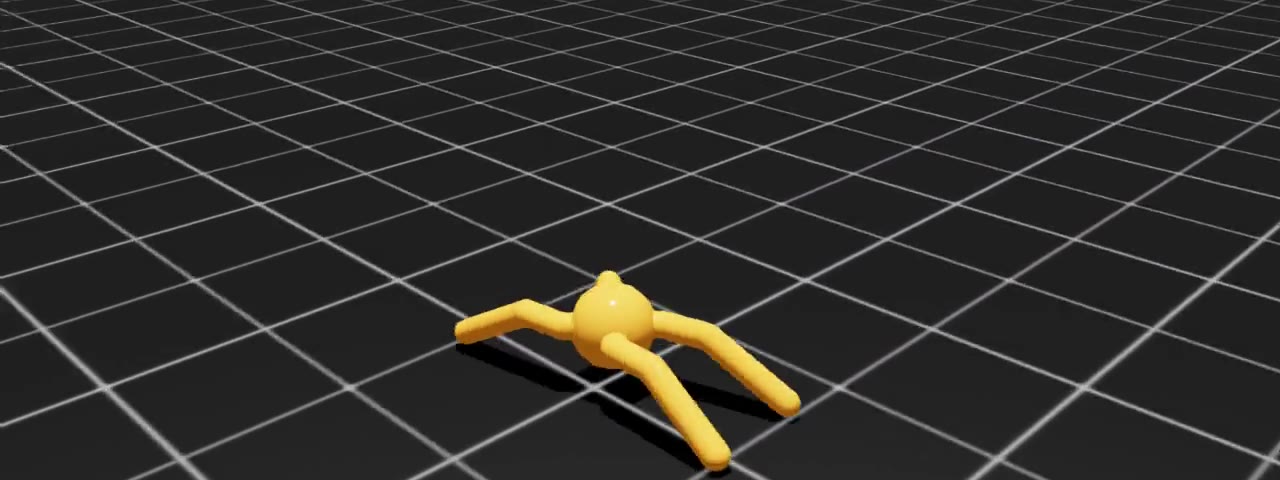
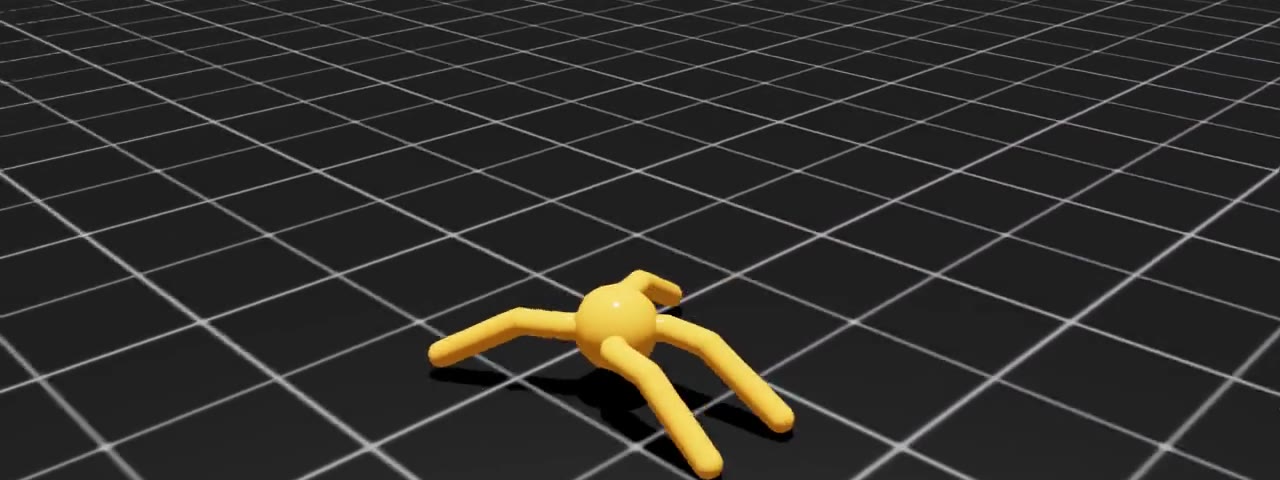
60 秒耐力测试。评估时将回合长度覆盖为 60 秒(env.episode_length_s=60.0,仅评估用)录制加时回放,检验长时间行走的持续性:
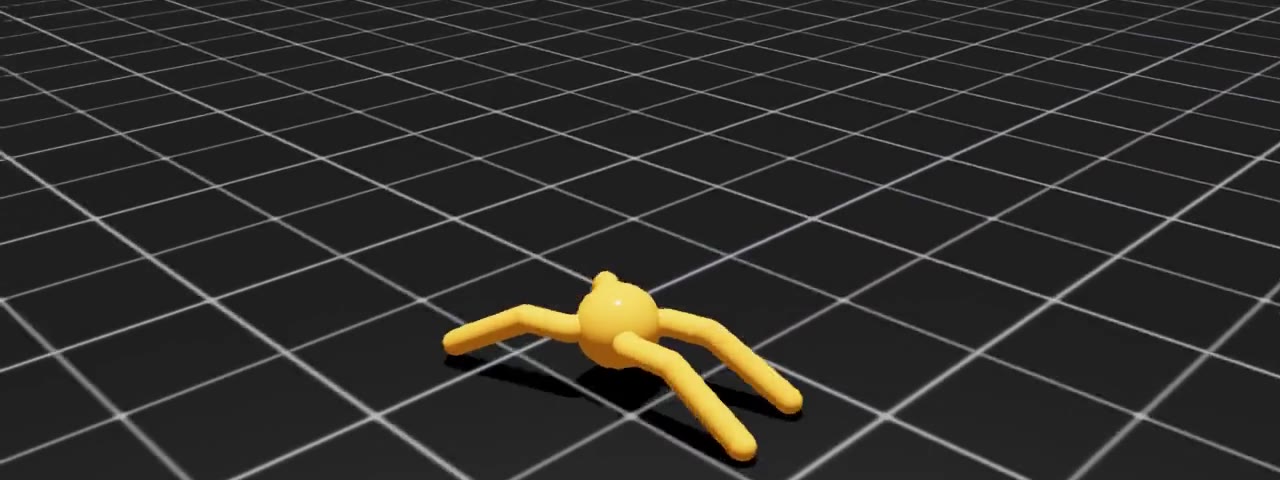 t ≈ 10 s
 t ≈ 35 s
 t ≈ 58 s
如图 10 所示,整段 60 秒回放中机器人持续行走、未发生摔倒。需要说明的是,这是单次回放的结果:训练统计中约 7% 的回合以摔倒终止(第 5.2 节),单次 60 秒不摔并不代表零摔倒率,只说明"持续行走一分钟"在该策略的正常能力范围之内。
6消融与对比实验
为检验两处设计选择的实际作用,本实验开展了 3 条件 × 3 种子共 9 个 run 的消融:各条件的覆盖参数如表 4 所示,除该单参数外所有 run 配置完全相同,种子取 42 / 43 / 44,统计口径为末 100 迭代均值的种子间均值 ± 标准差(n=3, ddof=1)。
| 条件 | 覆盖参数 | 检验目标 |
|---|---|---|
| baseline | 无(官方默认) | 对照组 |
| no-energy | env.rewards.energy.weight=0 | 能耗惩罚对步态与稳定性的作用(验证第 3.3 节"若移除"推断) |
| entropy | agent.algorithm.entropy_coef=0.005 | 本任务官方默认关闭熵正则(系数 0),开启后是否有益 |
9 个 run 的回报曲线如图 11 所示,关键指标汇总见表 5:
| 指标 | baseline | no-energy | entropy (0.005) |
|---|---|---|---|
| 平均回报 | 120.4 ± 3.2 | 200.4 ± 8.0 † | 157.0 ± 4.1 |
| 前进速率(progress,每秒) | 7.83 ± 0.34 | 11.82 ± 0.45 | 10.44 ± 0.17 |
| 摔倒占比 | 7.0% ± 0.7% | 13.9% ± 2.4% | 6.7% ± 0.4% |
| 动作幅值惩罚(action_l2,每秒) | −0.018 ± 0.002 | −0.049 ± 0.004 | −0.032 ± 0.003 |
| 末段探索噪声(mean_std) | 0.050 ± 0.020 | 0.118 ± 0.006 | 0.151 ± 0.037 |
† no-energy 组的奖励函数缺少能耗扣分项,其"平均回报"与另两组不可直接比较;跨组比较请以 progress、摔倒占比等公共指标为准。
能耗惩罚(no-energy vs baseline)。移除能耗惩罚后,策略的前进速率提升约 51%(11.82 对 7.83),但代价同样明确:摔倒占比由 7.0% 升至 13.9%(约翻倍),动作幅值惩罚扩大至 2.7 倍,末段探索噪声也高于基线——策略学出的是更大力矩、更激进的步态。这验证并细化了第 3.3 节的推断:能耗惩罚并非可有可无的正则项,而是以牺牲部分速度为代价、换取更稳且更省力步态的显式权衡。是否保留取决于任务目标:若只追求仿真里的速度指标可以移除,面向真机部署(能耗、电机发热、跌倒风险都是实际成本)则应保留。
熵正则(entropy vs baseline)。两组奖励函数相同,回报可直接比较:开启 entropy_coef=0.005 后平均回报提升约 30%(157.0 ± 4.1 对 120.4 ± 3.2,种子间误差带不重叠),前进速率提升约 33%,而摔倒占比持平(6.7% 对 7.0%)。机制上可从探索噪声看出:基线的 σ 收缩至 0.050,而熵组维持在 0.151——熵奖励阻止了动作分布过早塌缩,更持久的探索找到了更快的步态,且没有以稳定性为代价。据此,官方默认的 entropy_coef=0 在本任务、本训练预算下并非最优;该发现将带入后续 G1 实验验证其普适性。
两点保留:以上结论基于 1000 次迭代的固定预算与 n=3 的小样本,更长训练下基线可能部分追平熵组;消融只覆盖了两个单参数,未做参数扫描与交互作用分析。
7局限性
本报告存在四点局限:
- 直接读取训练曲线。本报告未设置独立评估流程(固定初始状态、关闭探索噪声、多回合统计);独立评估管线仍待建设。
- 无域随机化与外部扰动。平地、无推搡、无参数随机化,摔倒率 7% 是"温室"条件下的数字;鲁棒性将在 G1 地形任务中用域随机化正面处理。
- 消融覆盖有限。仅两个单参数、单一训练预算、n=3 种子;结论的外推(更长训练、其他任务)需进一步验证。
- 定性分析基于单次回放。60 秒不摔为单样本证据,与训练统计中 7% 的摔倒率并存,不应过度解读。
3 种子设计缓解了单次运行偶然性的局限,但样本量仍然较小。
8结论与未来工作
结论。PPO 在 1000 次迭代(约 1.31 亿步、单 run 训练循环约 4.9 分钟)内学会了 Ant 的四足行走:平均回报 129.9、回合长度 951/960,跟随镜头回放确认稳定的交替步态,60 秒加时行走未摔倒;3 种子重复实验(120.4 ± 3.2)表明结果稳健。消融给出两条有实证支撑的结论:能耗惩罚是速度与稳定性/能耗之间的显式权衡(移除后速度 +51% 但摔倒率翻倍);熵正则在本任务显著有益(+30% 回报且不损稳定性),官方默认关闭并非最优。本任务收敛后仍有约 7% 的摔倒率,且回报仍在缓慢爬升;行走问题的难度长尾开始显现。
未来工作。下一个实验为 G1 人形平地行走:从四足到双足,稳定裕度大幅缩小,并将引入速度指令跟踪(不再是单向冲刺)。熵正则的发现与独立评估管线将在该实验中落实。
附录 · 关于本报告
理论深度。本报告的理论仅陈述至读懂实验所需的程度;PPO、GAE 与连续控制的完整推导参阅下列文献。
数据来源。全部配置数值取自 Isaac Lab 2.3.2 源码与 run 目录的参数快照;曲线与统计来自 9 个真实 run 的本地 TensorBoard 事件文件(主 run 2026-07-07_08-19-22_base-s42;消融批次 base-s43/s44、noenergy-s42/43/44、entropy-s42/43/44,均为 2026-07-07 同机连续训练);训练耗时与参数量分别实测自事件文件与检查点 model_999.pt;回放视频由跟随镜头版 play 脚本录制。均未作人工修饰。
参考文献。
- J. Schulman, F. Wolski, P. Dhariwal, A. Radford, O. Klimov. Proximal Policy Optimization Algorithms. arXiv:1707.06347, 2017.(PPO 原论文)
- J. Schulman, P. Moritz, S. Levine, M. Jordan, P. Abbeel. High-Dimensional Continuous Control Using Generalized Advantage Estimation. arXiv:1506.02438, 2015.(GAE 原论文)
- N. Rudin, D. Hoeller, P. Reist, M. Hutter. Learning to Walk in Minutes Using Massively Parallel Deep Reinforcement Learning. CoRL 2021, arXiv:2109.11978.(rsl_rl 训练框架)
- M. Mittal et al. Orbit: A Unified Simulation Framework for Interactive Robot Learning Environments. IEEE RA-L, 2023, arXiv:2301.04195.(Isaac Lab 前身,本实验环境来自其官方任务包)
- R. S. Sutton, A. G. Barto. Reinforcement Learning: An Introduction (2nd ed.). MIT Press, 2018.(强化学习标准教科书)