G1 29 自由度平地行走与 Sim2Sim 迁移
摘要:本实验研究 Unitree G1 人形机器人 29 自由度构型在平地上的速度跟踪,并检验所得策略能否零样本迁移到另一物理引擎。策略以真机可获取量为输入:一个 480 维、不含躯干线速度的速度盲观测(真实机器人无法直接测得底盘线速度),由非对称 Actor-Critic 训练——Actor 只看速度盲观测,Critic 额外获得仅存在于仿真中的特权躯干线速度以稳定价值估计。以 RSL-RL PPO 在 4096 个并行环境中训练 normal 与 fast 两档、各 10000 次迭代(种子 42):normal 末 100 迭代平均回报 42.37 ± 0.23、平均回合长度 990.99 步、倾斜终止占 0.32%。随后将 normal / fast 策略部署进同一 29 自由度 URDF 的 MuJoCo 模型。首次部署在约 0.6 秒内倾倒;经逐层排查,根因是部署器把训练侧的隐式 PD 阻尼错当外部力矩显式施加,致关节速度从第一步起高频振铃。将阻尼交回积分器隐式处理、并清除训练时根本不存在的库仑摩擦后,normal 走出 8.87 m、fast 走出 17.77 m、12 秒零倾倒,与 Isaac 侧的 8.03 / 16.63 m 吻合,迁移干净打通。
| 状态 | 已训练 ✓ normal / fast 两档(种子 42) |
| 机器人 | Unitree G1 29 自由度(腿 12 + 腰 3 + 臂 14,无手);29 个关节全部受策略控制;隐式 PD 关节位置执行器 |
| 技术路线 | 强化学习 · PPO · RSL-RL |
| 任务环境 | Unitree-G1-29dof-Velocity(unitree_rl_lab 的 Isaac Lab Manager-based 任务) |
| 任务配置 | 自定义 cfg 子类(overlay):RobotNormalEnvCfg / RobotFastEnvCfg 把前进速度命令范围直接设死,不改官方奖励与观测逻辑;指向 configs 下的变体类 |
| 并行环境数 | 4096 |
| 迭代数 | 10000(每档) |
| 训练设备 | NVIDIA GeForce RTX 5070 Ti(16 GB) |
| 真实训练耗时 | normal 约 11,849 秒(3.29 小时);fast 约 11,403 秒(3.17 小时) |
| 观测 / 动作维度 | Actor 480 维(速度盲)→ 29 维动作;Critic 495 维(含特权躯干线速度)→ 标量价值 |
| 策略网络 | Actor 480→512→256→128→29(实测 414,266 参数);Critic 495→512→256→128→1(实测 418,305 参数);合计 832,571 |
| 最终指标(normal) | 末迭代回报 41.74 / 末 100 迭代 42.37 ± 0.23;平均回合长度 990.99 步;倾斜终止 0.32% |
1背景与问题定义
本任务要求 G1 在平地上跟踪随机采样的底盘速度命令。系统与任务目标如图 2 所示:机器人需在不让躯干或骨盆接触地面、且躯干不过度倾斜的前提下,跟踪前进速度、侧向速度与偏航角速度命令。
base_velocity 生成,普通档把前进速度上限设为 1.0 m/s;躯干或骨盆发生非法接触、或躯干倾角超过阈值时回合失败终止。机器人:Unitree G1 的 29 自由度构型,关节按部位构成为——双腿 12 个(每侧 hip_pitch / hip_roll / hip_yaw / knee / ankle_pitch / ankle_roll,共 6 × 2),腰部 3 个(waist_yaw / waist_roll / waist_pitch),双臂 14 个(每侧 shoulder_pitch / shoulder_roll / shoulder_yaw / elbow / wrist_roll / wrist_pitch / wrist_yaw,共 7 × 2)。该构型不含灵巧手,腕关节即为每条手臂的末端。29 个关节全部由策略动作控制。
控制:控制量不是期望速度本身,而是与上述 29 个关节一一对应的关节位置偏移。如图 3 所示的因果链为:策略输出 29 维动作 a → 乘以动作尺度 0.25 并叠加到默认关节姿态 q₀ → 得到关节位置目标 q* → 由隐式 PD 执行器在物理仿真中解算出关节力矩 τᵢ → 形成站立、摆腿、接触节律与速度跟踪。中间没有任何手写步态控制器,全部行为由 PPO 策略与物理闭环共同学出。
a,经 q* = q₀ + 0.25a 转为 29 个关节位置目标 qᵢ*,分别落到双腿、腰部与双臂的受控关节;隐式 PD 执行器再据此在物理仿真中产生关节力矩 τᵢ。目标:最大化折扣累计奖励,使机器人在 20 秒训练回合内持续保持直立、不摔倒,并尽量准确跟踪命令 (vₓ, vᵧ, ωz)。按 MDP 表述,问题定义见表 2。
| 环境 | 4096 个并行 Isaac Lab GPU 物理环境,平地,控制频率 50 Hz |
| 智能体 | RSL-RL PPO 的非对称 Actor-Critic 策略 |
| 状态 / 观测 | Actor:480 维速度盲本体观测与速度命令;Critic:495 维特权观测(额外含躯干线速度),构成见表 3 |
| 动作 | 29 维关节位置目标偏移,动作尺度 0.25,构成见第 3.2 节 |
| 奖励 | 19 项加权和,主目标为线速度 / 偏航速度跟踪,辅以存活、步态与稳定性塑形,见表 4 |
| 回合 | 20 秒到时正常结束;躯干 / 骨盆触地或躯干倾角超限提前终止 |
| 目标 | 最大化折扣累计回报,折扣因子 γ = 0.99 |
2理论基础
2.1PPO 与在线策略 Actor-Critic
本实验采用 PPO 作为连续控制算法。第 1 节的速度跟踪任务具有高维连续动作、长时序稳定性要求与大规模并行仿真的特征,适合在线策略(on-policy)Actor-Critic:Actor 产生连续动作分布,Critic 估计状态价值以降低策略梯度方差。全文用到的理论概念在此一次性定义。优势(advantage)衡量某动作相对当前策略平均水平的好坏,本实验用广义优势估计 GAE(λ) 计算,λ = 0.95,在偏差与方差之间折中。策略损失采用 PPO 的裁剪替代目标:对新旧策略概率比施加 ±0.2 的裁剪,避免单次更新过大导致步态崩溃。价值损失让 Critic 拟合折扣回报。熵正则项控制动作分布的随机性,系数越高越鼓励探索;本实验取 0.01。σ 记动作标准差,动作分布记为 N(μ, σ²)。
2.2非对称 Actor-Critic 与速度盲观测
本实验的关键设计是观测的非对称。真实机器人无法直接测得底盘线速度——它没有对应的真值传感器,只能靠状态估计间接推断且带噪声。为使训练所得策略只依赖硬件上真实可得的量(惯性单元的角速度、由重力方向推得的姿态、关节编码器读数、上一步动作与命令),Actor 的观测刻意剔除躯干线速度,即所谓速度盲观测(480 维)。与此同时,Critic 只在训练期使用,可以自由取用仿真中免费提供的特权信息,因此给它补上躯干线速度(495 维)。这样做的收益是:更准的价值估计降低了优势估计的方差、稳定了训练,而这一特权量不会污染最终要部署的 Actor。这是非对称 Actor-Critic 的标准思路(Pinto 等人,2017)——它把"用于降方差的上帝视角"限制在 Critic 内部,让 Actor 保持在真机可复现的观测子集上。第 6 节的迁移正是对这一设计前半段(跨引擎可迁移性)的检验。
3实验框架
3.1网络结构
Actor 与 Critic 均为三层 MLP(隐藏层宽度 512、256、128,激活 ELU),但输入与输出不同:Actor 输入 480 维、输出 29 维动作均值并配 29 个可学习的对数标准差 logσ,构成对角高斯策略;Critic 输入 495 维、输出标量价值。结构如图 4 与图 5 所示。实测自检查点 model_9999.pt:Actor 共 414,266 个参数(含 29 个 logσ),Critic 共 418,305 个参数,合计 832,571。
3.2观测与动作
Actor 观测由 6 类本体量按项序拼接、并叠加 5 步历史构成,如表 3 所示:每帧 3 + 3 + 3 + 29 + 29 + 29 = 96 维,乘 5 步历史得 480 维,其中不含躯干线速度。Critic 在同样 6 类之外再加躯干线速度,每帧 99 维、乘 5 步得 495 维。动作为 29 维关节位置目标偏移,经动作尺度 0.25 缩放后叠加默认关节位置,得到发给隐式 PD 执行器的目标关节位置。
| 项 | 每帧维度 | 含义 | Actor | Critic |
|---|---|---|---|---|
base_lin_vel | 3 | 躯干线速度(特权量,真机不可直接测) | — | ✓ |
base_ang_vel | 3 | 躯干角速度(缩放 0.2) | ✓ | ✓ |
projected_gravity | 3 | 重力方向在机体系的投影,表征姿态 | ✓ | ✓ |
velocity_commands | 3 | 目标 vₓ、vᵧ、ωz | ✓ | ✓ |
joint_pos_rel | 29 | 关节相对默认位置 | ✓ | ✓ |
joint_vel_rel | 29 | 关节相对速度(缩放 0.05) | ✓ | ✓ |
last_action | 29 | 上一步动作 | ✓ | ✓ |
| 每帧合计 | — | Actor 96 · Critic 99 | 96 | 99 |
3.3奖励函数
奖励在每个控制步按 权重 × 控制步长 累加,因此权重是"每秒得分速率"而非单步得分(控制步长 0.02 秒)。本任务的奖励构成模式是"主目标跟踪 + 稳定塑形":两项指数核跟踪项提供正向主目标,存活与步态项维持行走节律,其余负权重项约束姿态、能量与不良接触。19 个活跃奖励项与权重见表 4。需要指出的是,该表不含 feet_air_time 与 termination_penalty,且带一个固定 0.8 秒周期的 gait 步态相位锁——它奖励的是行走节律而非奔跑腾空,这决定了普通档策略呈现的是稳定步行步态。
| 奖励项 | 权重 | 作用 |
|---|---|---|
track_lin_vel_xy_yaw_frame_exp | +1.0 | 指数核跟踪机体系 xy 线速度命令(std = 0.5) |
track_ang_vel_z_exp | +0.5 | 指数核跟踪偏航角速度命令(std = 0.5) |
alive | +0.15 | 每步存活奖励 |
gait | +0.5 | 双足步态相位锁(周期 0.8 s、相位偏移 [0, 0.5]、阈值 0.55) |
feet_clearance | +1.0 | 奖励摆动脚抬升到目标离地高度 0.1 m |
feet_slide | −0.2 | 惩罚触地脚滑动 |
lin_vel_z_l2 | −2.0 | 惩罚竖直方向线速度 |
ang_vel_xy_l2 | −0.05 | 惩罚横滚 / 俯仰角速度 |
flat_orientation_l2 | −5.0 | 惩罚躯干偏离水平姿态 |
base_height_l2 | −10 | 惩罚偏离目标身高 0.78 m |
joint_vel_l2 | −0.001 | 惩罚关节速度 |
joint_acc_l2 | −2.5e−7 | 惩罚关节加速度 |
action_rate_l2 | −0.05 | 惩罚连续动作变化过大 |
dof_pos_limits | −5.0 | 惩罚关节接近位置限位 |
energy | −2e−5 | 惩罚机械能耗 |
joint_deviation_arms | −0.1 | 限制双臂(肩 / 肘 / 腕)偏离默认姿态 |
joint_deviation_waists | −1 | 限制腰部三关节偏离默认姿态 |
joint_deviation_legs | −1.0 | 限制髋 roll / yaw 偏离默认姿态 |
undesired_contacts | −1 | 惩罚非足部部位接触 |
3.4终止与复位
终止条件有三项:time_out(20 秒到时,即 1000 个控制步)、base_height(根部世界系高度低于 0.2 m)与 bad_orientation(躯干倾角超过 0.8 rad)。后两项即"摔倒"。复位时根位姿在 x / y / yaw 范围内随机化,关节以默认姿态复位并叠加小幅速度扰动。训练环境每 5 秒对躯干施加一次小幅速度推搡(±0.5 m/s)作为扰动事件。
3.5训练流程
每次迭代中,PPO 先在 4096 个并行环境中各收集 24 个控制步,共 98,304 条 transition;随后以 4 个 mini-batch、5 个 learning epoch 更新非对称 Actor-Critic。10000 次迭代对应约 9.83 亿控制步。学习率按目标 KL 0.01 自适应调整。
3.6环境与超参数
任务采用 Isaac Lab 的 Manager-based 工作流:场景、观测、动作、奖励、终止、事件、curriculum 各由独立的 Manager 装配。软硬件环境只列版本,通用超参逐项附取值依据。
复现命令。下列命令在 ~/unitree_rl_lab 下运行;--task 指向本实验注册的普通档变体(快走档改为 -Fast),命令范围由该变体的 cfg 子类设死。
python scripts/rsl_rl/train.py --task Unitree-G1-29dof-Velocity-Normal --headless --num_envs 4096 --max_iterations 10000 --seed 42
4实验结果
normal 与 fast 两档均完成 10000 次迭代并写出最终检查点,训练耗时分别约 11,849 秒与 11,403 秒(单卡吞吐口径)。normal 档的全部训练曲线如图 6 所示。末段读数为:normal 末迭代回报 41.74、末 100 迭代 42.37 ± 0.23、平均回合长度 990.99 步(满值 1000);fast 末迭代回报 34.97、末 100 迭代 34.62 ± 0.32。
如图 6 所示,回报在前段快速上升后进入长时间的缓慢精修;平均回合长度早早接近 1000 步,说明绝大多数回合以到时正常结束。
5实验分析
5.1学习过程
图 6 显示,normal 策略在前段由低回报迅速进入稳定站立与初步跟踪,随后回报缓慢抬升。平均回合长度接近满值后,学习重点从"不摔倒"转向速度跟踪误差与动作平滑度的精修。这一形态说明本任务的主要难点不是单次站立,而是 29 个关节在持续速度命令下的长时协调。
5.2辅助指标
终止统计与回报曲线互证:normal 末段的终止构成为 time_out 99.68%、bad_orientation 0.32%、base_height 0%——即摔倒几乎只以躯干过度倾斜的形式偶发,且占比稳定在 1% 以下但未完全消失,这与人形机器人在转向命令下偶发失稳一致。平均回合长度 990.99 步进一步确认多数回合走满全程。
5.3命令范围对照
normal 与 fast 两档只差前进速度命令的上限(1.0 对 2.0 m/s),其余奖励、观测、网络与超参完全一致。两档回报曲线的对照如图 7 所示:更高的速度命令带来更低的末段回报(normal 42.37 ± 0.23 对 fast 34.62 ± 0.32),因为更快的行走更难同时满足姿态、能量与步态约束;但两档都稳定收敛、回合长度均接近满值,表明速度上限的提高并未破坏训练的稳定性。本对照仅覆盖单一随机种子(42),故只作为当前预算下的趋势读,不作跨种子统计结论。
5.4策略行为
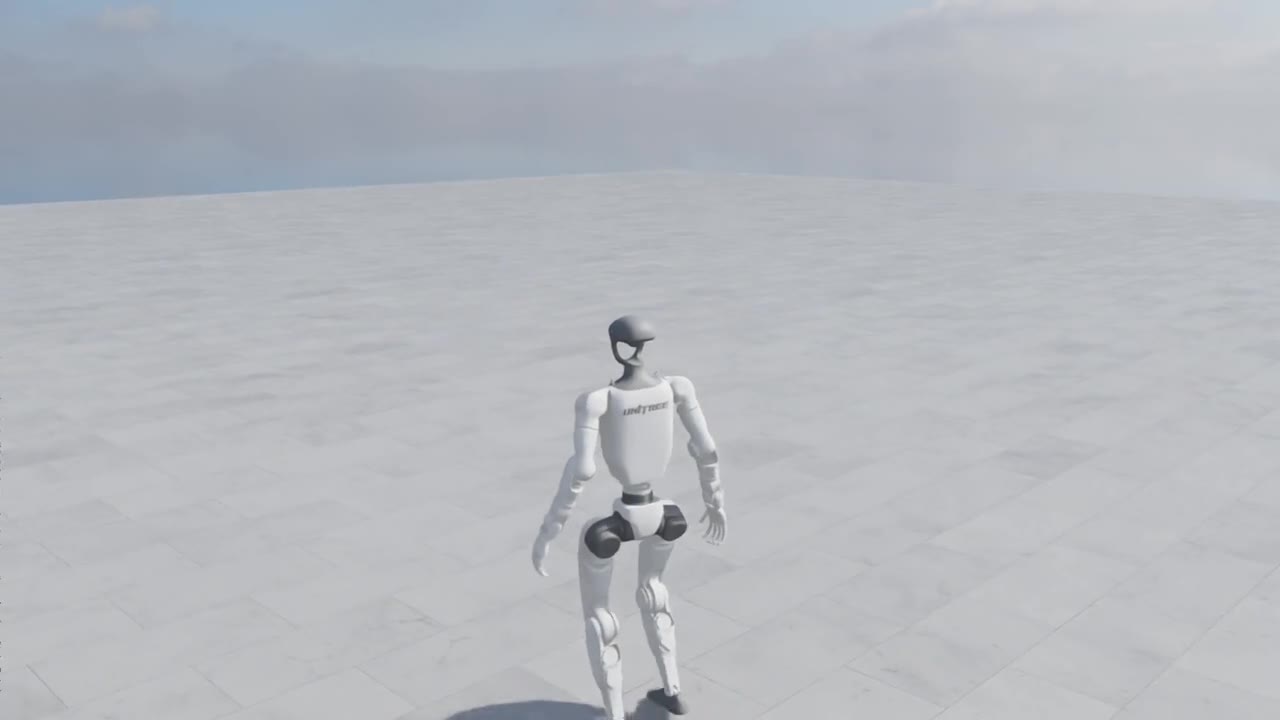
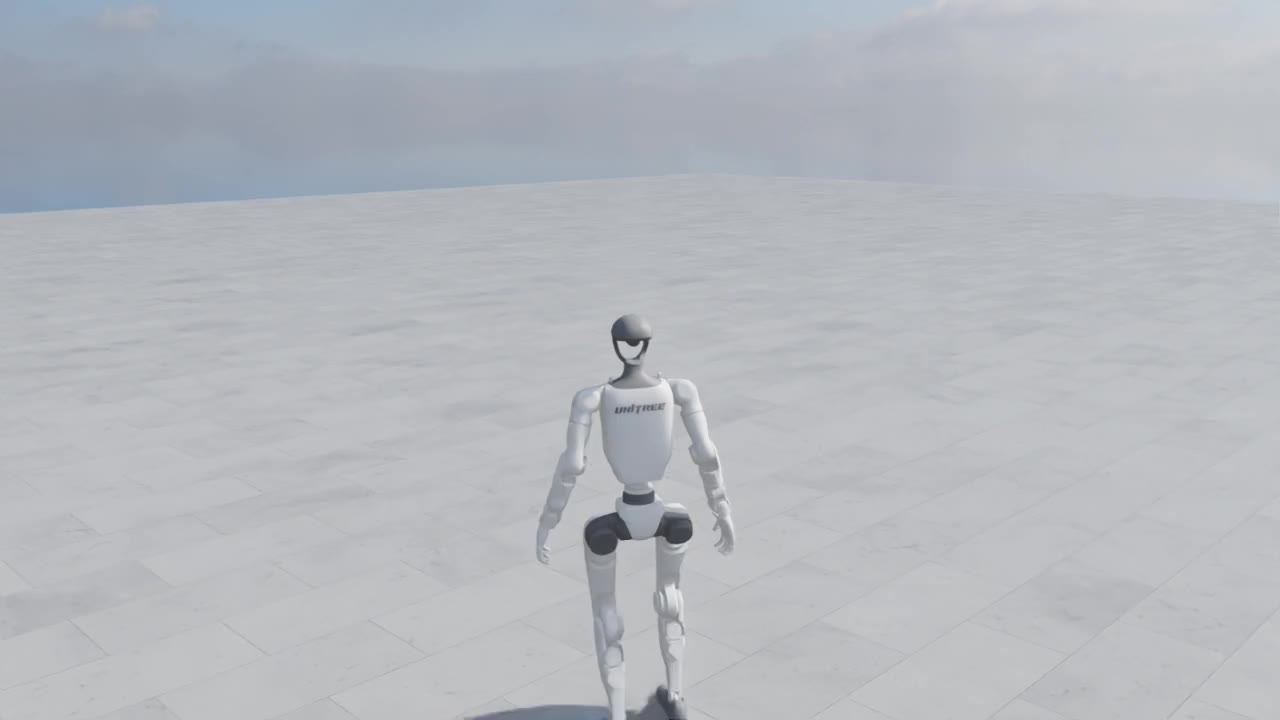
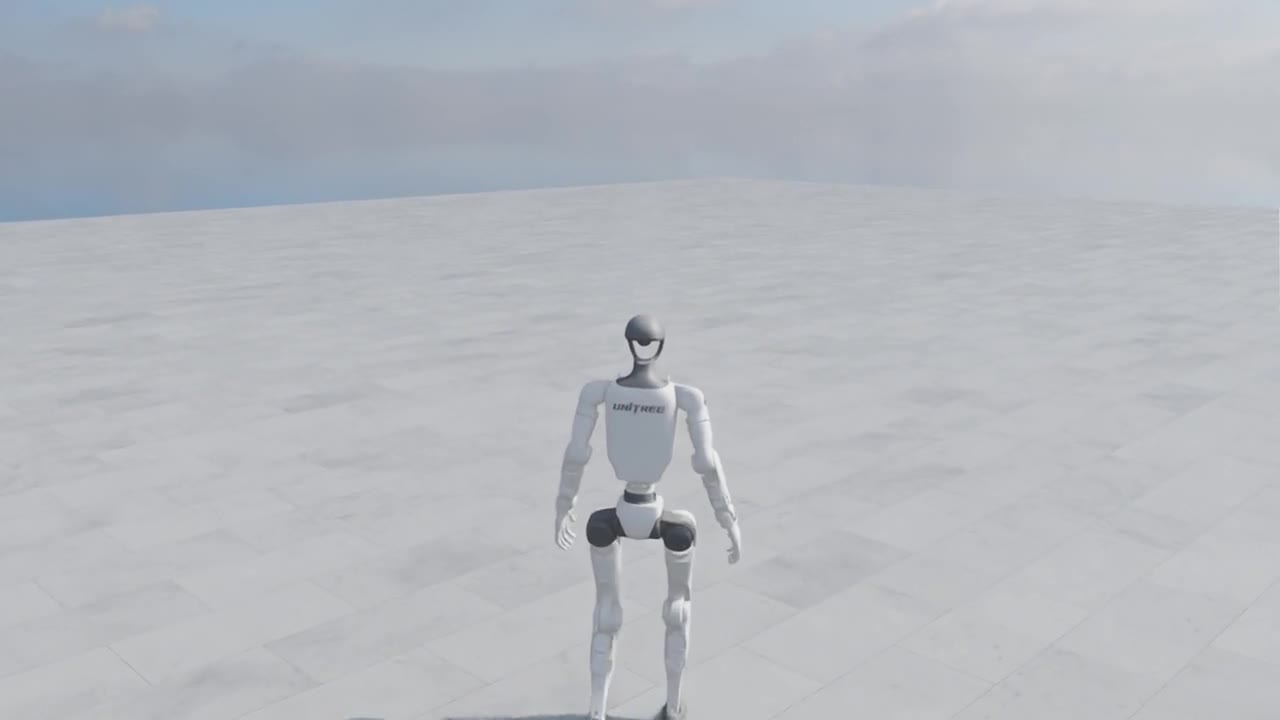
下面的回放为 normal 策略在 Isaac Lab 中、以固定前进命令 0.8 m/s 直行的跟随镜头录制。相机原点绑定机器人根部并给定固定视角偏移,只影响可视化、不改变动力学或策略输入。
 起步
 中段
 末段
如图 8 所示,机器人维持直立、连续迈步并稳定前进;步态偏保守,摆臂与腰部有可见的姿态补偿。
6Sim2Sim 迁移
训练全程在 Isaac Lab 的 PhysX 引擎中进行。一个自然的问题是:策略究竟学到了"行走"这项可迁移的技能,还是过拟合到了 PhysX 的具体动力学?为回答它,本节把训练所得的 normal / fast 策略零样本部署进 MuJoCo——两边使用同一个 29 自由度 URDF,只更换物理引擎,构成一次干净的 sim2sim。部署照 Unitree 官方 deploy_mujoco 配方:PD 力矩、物理步长 0.005 秒、控制 50 Hz。
诊断链(单变量逐层剥离)。首次部署在约 0.6 秒内前倾倒地。排查按单一变量逐层进行:
(一)作动器模型。旧部署器复刻了 Unitree 的电机模型——带方向相关的力矩-转速饱和曲线与库仑摩擦(静摩擦 Fs ≤ 2.4)。但逐行核对训练侧配置发现,训练用的是 ImplicitActuatorCfg:纯隐式 PD、电枢惯量 0.01、平直力矩上限,既无库仑摩擦也无力矩-转速曲线;而那个带摩擦的 UnitreeActuator 类经全仓检索确认未接入任何 G1 配置。也就是说,旧部署器凭空引入了训练时根本不存在的阻力。改回纯 PD、平直限幅后,倾倒时刻由 0.60 秒延到 0.78 秒、位移由 0.93 m 增至 2.38 m——这个电机模型一直在帮倒忙。
(二)物理步长。把步长由 0.005 秒缩短到 0.002 秒(更稳的接触求解),倾倒时刻进一步延到 1.44 秒。属次要因素。
(三)金标准 trace 逐步对拍。用同一 onnx、同一起步,在 Isaac 与 MuJoCo 各跑一遍闭环并逐步比对:关节位置与躯干朝向跟得很紧(重力投影逐步差 0.003–0.02),但关节速度从第 1 步就发散到 L2 范数约 38 并维持不降——这是典型的关节速度高频振铃。位置靠积分平均尚能维持,但策略每步都收到失真的关节速度观测。
(四)根因与修复。振铃源于显式 stiff PD 的不稳定:Isaac 的隐式执行器把 kd 阻尼项放在求解器内部隐式积分(无条件稳定),而旧部署器把 −kd·q̇ 当作外部力矩显式施加,在 kp = 100–200 的腿部关节上振荡。修复方法是把 kd 交给 MuJoCo 的 model.dof_damping(半隐式积分)、力矩只发 kp·(q*−q) 并平直限幅、同时清除那套不存在的摩擦——这就等价于 Isaac 的隐式 PD。修复后关节速度逐步差由 38 降到 3,振铃消失。
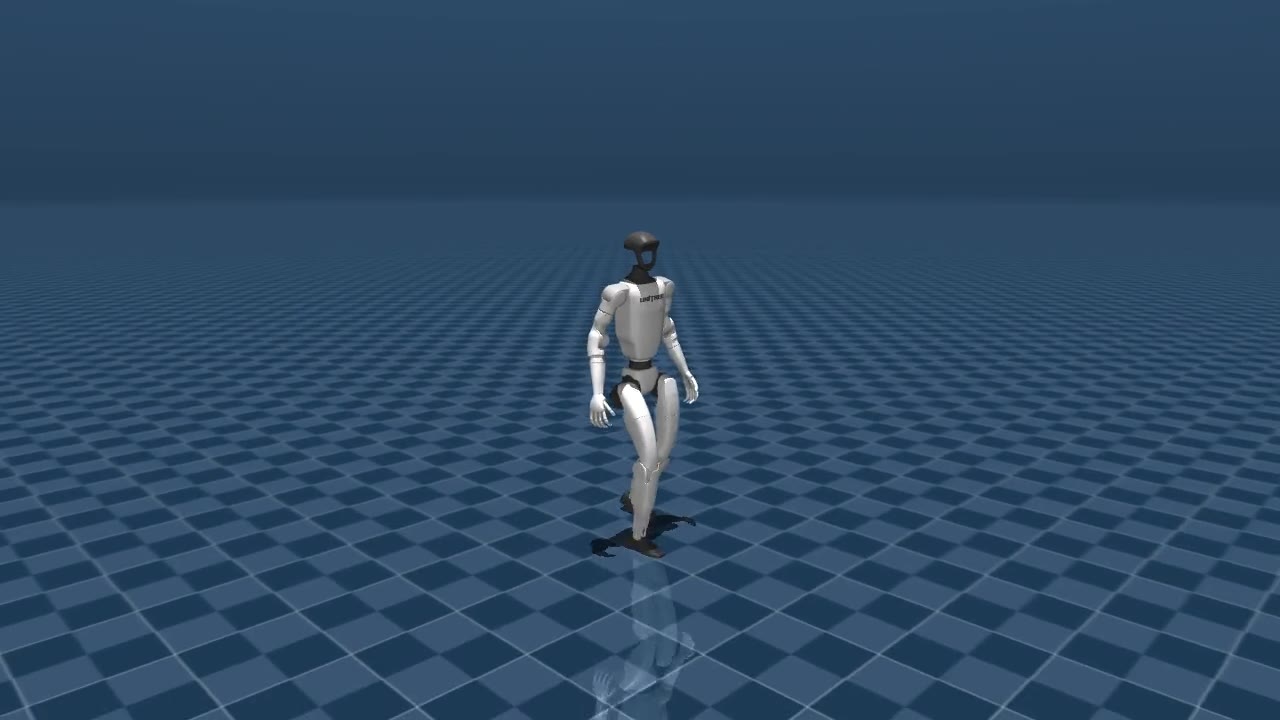
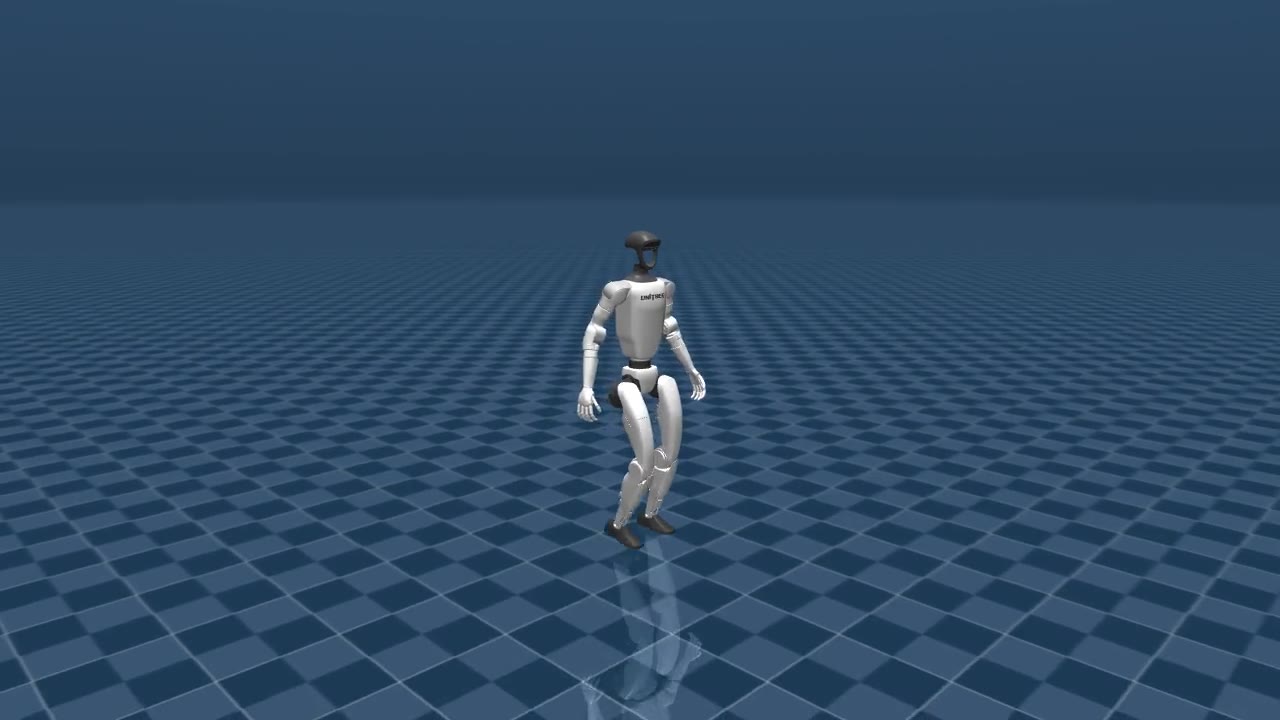
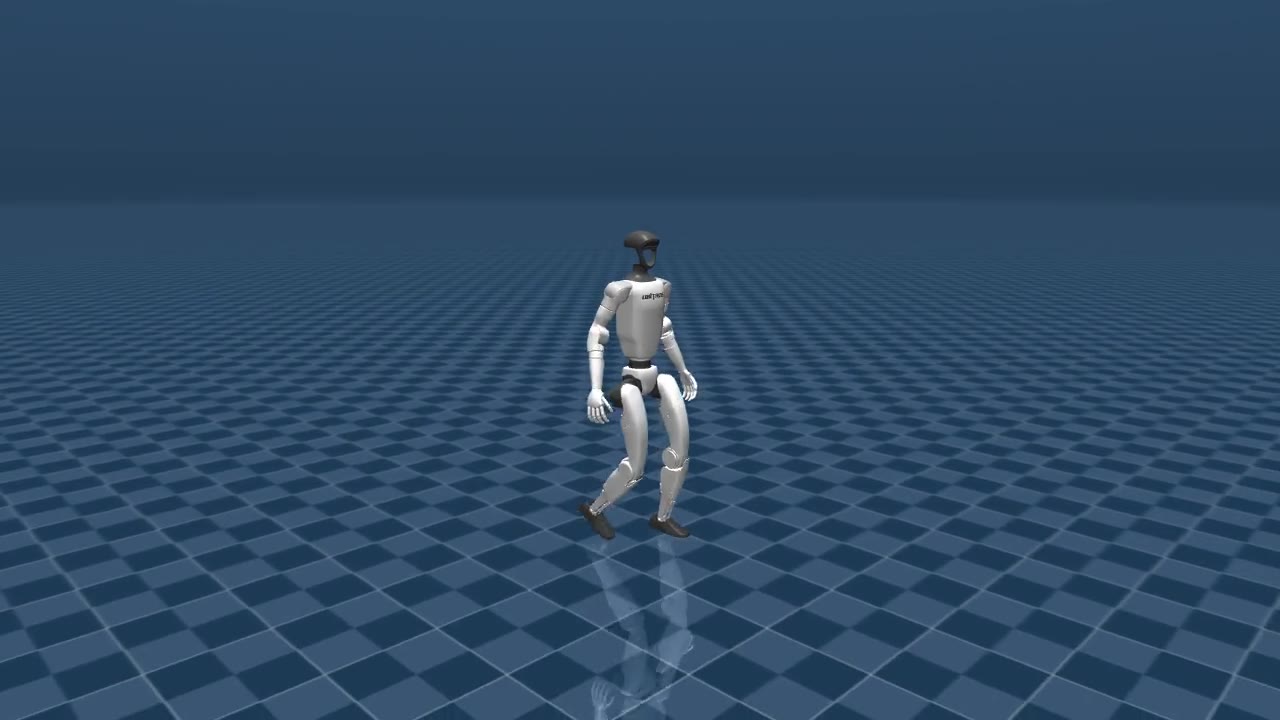
修复后的迁移成绩见表 5:normal 走出 8.87 m、fast 走出 17.77 m、转向命令下走出 6.18 m,均为 12 秒零倾倒,与 Isaac 侧读数高度吻合。位移口径为净位移(‖末位置 − 初位置‖)。
| 策略 / 命令 | MuJoCo 净位移 | 是否倾倒 | Isaac 侧对照 |
|---|---|---|---|
| normal(10k)· vₓ = 0.8 m/s | 8.87 m | 未倒 | 8.03 m |
| fast · vₓ = 1.5 m/s | 17.77 m | 未倒 | 16.63 m |
| normal · vₓ = 0.6 m/s + ωz = 0.2 rad/s(转向) | 6.18 m | 未倒 | — |
一段诚实的插曲。在定位到部署 bug 之前,曾假设闭环倾倒是训练量不足所致(官方可部署策略训 50000 迭代,本实验为 10000 级),并据此把 normal 档续训到 30000 迭代作对照。结果 30k 与 10k 在 Isaac 侧成绩完全一致(净位移均为 8.03 m、零摔),而在旧部署器下二者同样在约 0.6 秒倾倒。这说明训练量从来不是瓶颈——10000 迭代已经足够,倾倒的真正原因是上述部署缺陷。这段 30k 对照虽属多余,却反过来干净地排除了"稳健性 = 训练量"的假设。
下面两段为修复后 MuJoCo 中的实际回放。第一段是 normal 策略走出 8.87 m 的成品,抽帧序列如图 9 所示。
 起步
 中段
 末段
第二段是 fast 策略走出 17.77 m 的成品回放。
7局限性
第一,本报告只覆盖单一随机种子(42);种子 43、44 的复现按工作流纪律留待后续,故所有数字不含跨种子统计。第二,sim2sim 迁移只对 normal / fast 的直线行走与一个转向命令做了确认;地形档(崎岖、楼梯等)未纳入迁移,且这些策略另有"锁定固定命令不前进"的独立问题,不在本报告范围。第三,全部实验都在仿真中完成,没有真实机器人部署。第四,480 维速度盲观测是面向真机可迁移性的设计选择,其"真机可复现"的后半段尚未在硬件上验证——本报告验证的是它能跨仿真引擎迁移,不能据此断言它已在真机上成立。第五,位移为定长回合下的单次测量,未做多次重复。
8结论与未来工作
本实验在 Unitree G1 的 29 自由度构型上,用面向真机格式的 480 维速度盲观测与非对称 Actor-Critic,训练出 normal / fast 两档可用的平地速度跟踪策略,并把它们干净地迁移到了另一物理引擎。迁移攻坚给出的核心工程结论是:跨引擎失败最初被误判为策略稳健性不足,实为部署器把隐式 PD 阻尼错当外部力矩显式施加所致的数值振铃;把阻尼交回积分器隐式处理后,10000 迭代的策略即可在 MuJoCo 中稳定行走、位移与 Isaac 侧吻合。后续工作包括:补齐多随机种子以形成统计结论;将迁移扩展到地形与域随机化;并最终推进到真实机器人,以检验速度盲观测设计在硬件上的可复现性。
附录 · 关于本报告
数据来源。任务与网络配置读取自 unitree_rl_lab 的 G1 29-dof velocity 配置与 run 目录的参数快照;训练曲线与末段统计来自 normal / fast 两档本地 TensorBoard 事件文件;真实训练耗时读自事件文件首末事件的墙钟时间差;参数量实测自检查点 model_9999.pt(Actor 414,266、Critic 418,305);Sim2Sim 的诊断结论、修复配方与迁移位移数字来自实验记录与部署工具 sim2sim/deploy_mujoco.py(文件头写明根因);MuJoCo 回放由该部署工具的录像模式导出。全部数字均为真实读数,未作修饰或外推。
参考文献。
- J. Schulman, F. Wolski, P. Dhariwal, A. Radford, O. Klimov. Proximal Policy Optimization Algorithms. arXiv:1707.06347, 2017.(PPO 原论文)
- J. Schulman, P. Moritz, S. Levine, M. Jordan, P. Abbeel. High-Dimensional Continuous Control Using Generalized Advantage Estimation. arXiv:1506.02438, 2015.(GAE 原论文)
- L. Pinto, M. Andrychowicz, P. Welinder, W. Zaremba, P. Abbeel. Asymmetric Actor Critic for Image-Based Robot Learning. arXiv:1710.06542, 2017.(非对称 Actor-Critic)
- N. Rudin, D. Hoeller, P. Reist, M. Hutter. Learning to Walk in Minutes Using Massively Parallel Deep Reinforcement Learning. CoRL 2021, arXiv:2109.11978.(RSL-RL 训练框架)
- Unitree Robotics. unitree_rl_lab, official Isaac Lab reinforcement-learning tasks and Unitree G1 29-dof configuration.(任务环境与官方部署配方来源)